AntwortenVeröffentlicht26 Quellen
Samsung zHBM: HBM direkt auf dem KI-Beschleuniger erklärt
Samsung will mit zHBM HBM direkt über einem KI Beschleuniger stapeln und verspricht dadurch mehr als die zehnfache Reaktionsgeschwindigkeit von KI Systemen. Für eine künftige zHBM Schnittstelle nennt Samsung als Zielwerte rund das Achtfache der HBM5 Leistung, mehr als die zehnfache Speicherdichte, dreifache Energiee...
Veröffentlicht vonBearbeitet mit GPT-5.6 TerraBilder erstellt mit GPT Image 2
Forschungsantwort
Wichtige Erkenntnisse
- Samsung will mit zHBM HBM direkt über einem KI Beschleuniger stapeln und verspricht dadurch mehr als die zehnfache Reaktionsgeschwindigkeit von KI Systemen.
- Für eine künftige zHBM Schnittstelle nennt Samsung als Zielwerte rund das Achtfache der HBM5 Leistung, mehr als die zehnfache Speicherdichte, dreifache Energieeffizienz und über 50 % geringeren Wärmewiderstand.
- Fachleute von OpenAI und Intel sehen CXL eher als zusätzliche Kapazitätsstufe für selten genutzte Daten – nicht als Ersatz für HBM bei der aktiven Ausführung von KI Modellen.
KI-Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
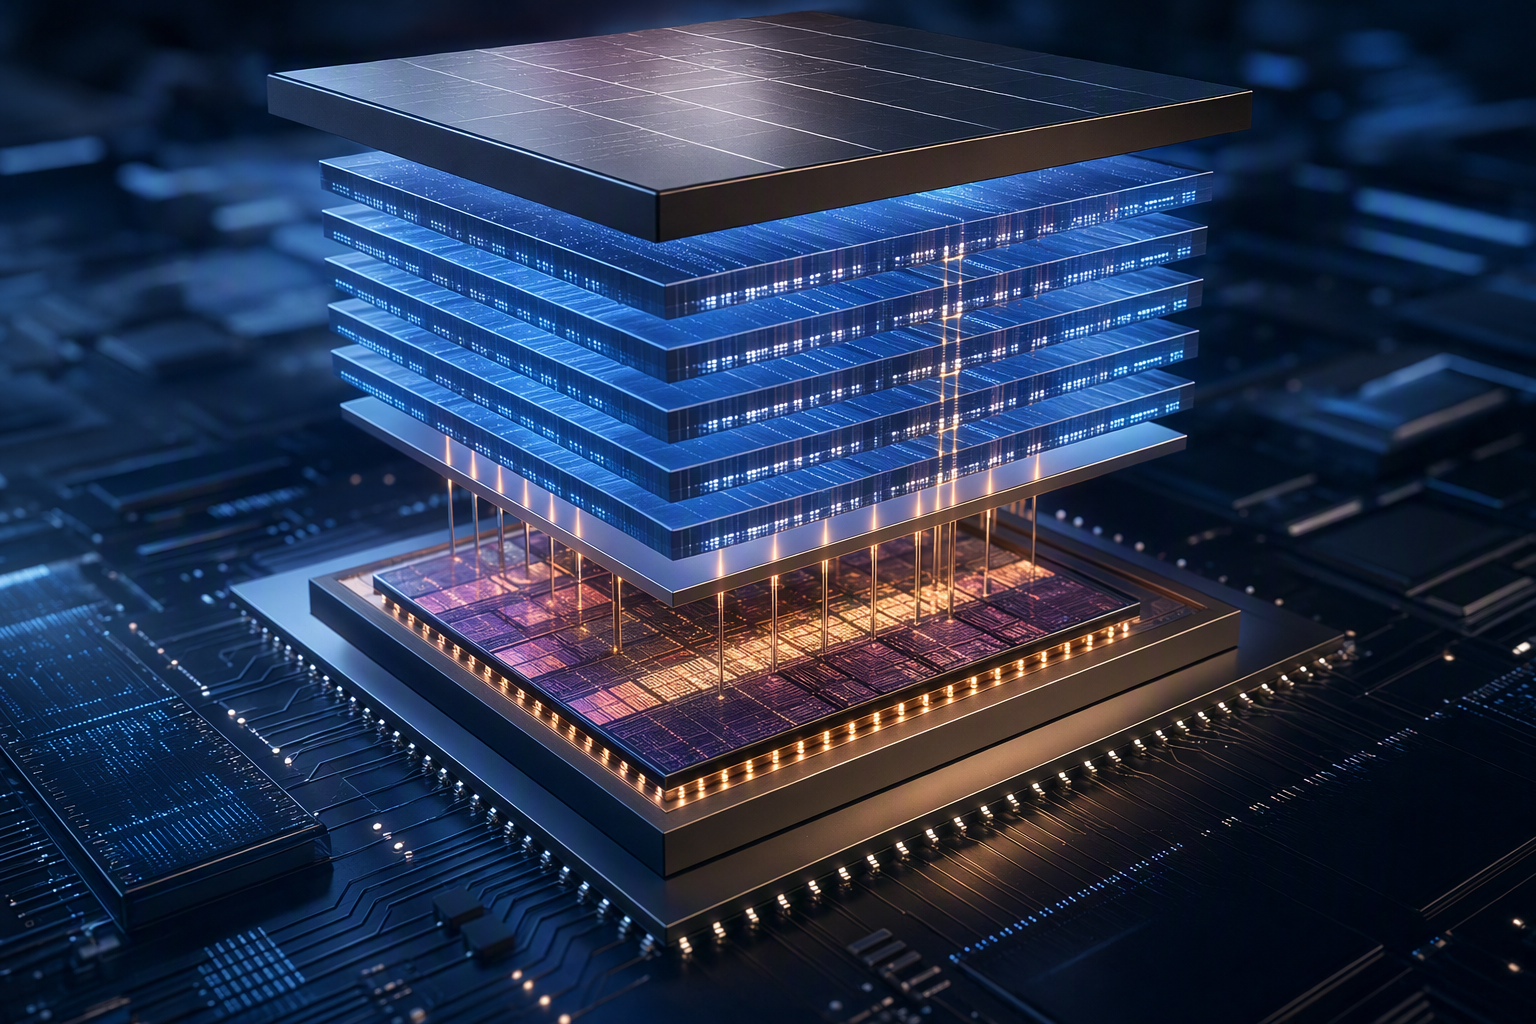
Samsung will den räumlichen Abstand zwischen KI-Rechenwerk und seinem schnellsten Speicher drastisch verkleinern. Bei zHBM soll High Bandwidth Memory (HBM) nicht wie bisher neben einer GPU oder einem anderen KI-Beschleuniger liegen, sondern direkt darüber in einem vertikal integrierten 3D-Package sitzen. Auf dem AI Infrastructure Summit am 16. September in Santa Clara stellte das Unternehmen diesen Ansatz als Baustein für reaktionsschnellere KI-Agenten vor. 1
9
Was ist anders als bei heutigen HBM-Packages?
In herkömmlichen HBM-Designs liegen Speicher und Beschleuniger meist nebeneinander auf derselben Ebene und werden durch fortschrittliche Gehäusetechnik verbunden. zHBM dreht dieses Layout gewissermaßen in die Höhe: Der HBM-Speicher wird direkt oberhalb des KI-Beschleunigers positioniert. Samsung spricht deshalb von einer 3D-Integration von Logik und Speicher. 12
13
Die Grundidee ist einfach: Kürzere Datenwege sollen die Bandbreite erhöhen, den Energiebedarf pro Datentransfer senken und mehr Speicherkapazität auf gleicher Fläche ermöglichen. Technisch setzt Samsung dafür auf Wafer-Bonding der nächsten Generation, einschließlich Hybrid Copper Bonding – einer präzisen Kupfer-Verbindungstechnik für die vertikale Integration. 7
48
Wichtig ist die Einordnung: zHBM ist bislang ein Konzeptmodell, kein angekündigtes Serienprodukt. Einen Zeitplan für die Kommerzialisierung hat Samsung nicht genannt. 13
14
Die Zielwerte: viel Potenzial, aber noch keine Produktbenchmarks
Für ein künftiges Schnittstellensystem mit zHBM nennt Samsung ambitionierte Zielgrößen:
- etwa 8-mal die Leistung von HBM5
- mehr als 10-mal die Speicherdichte von herkömmlichem HBM5
- rund 3-mal höhere Energieeffizienz
- mehr als 50 % geringeren Wärmewiderstand
13
48
Beim Summit erklärte Samsung zudem, zHBM könne die Antwortgeschwindigkeit von KI-Systemen um mehr als das Zehnfache steigern. Als Zielgröße nannte das Unternehmen 1.000 Token pro Sekunde. 1
9
Das sind Unternehmensprognosen für eine künftige Architektur, keine unabhängig bestätigten Messwerte eines verfügbaren Beschleunigers. Die Hürden sind erheblich: Direkt über der Logik gestapelter Speicher muss mit ausreichend hoher Ausbeute produziert werden, Wärme zuverlässig abführen und gemeinsam mit Partnern für Beschleuniger qualifiziert werden.
Warum das für KI-Agenten relevant sein kann
Samsung ordnet zHBM in die Entwicklung sogenannter KI-Agenten ein. Solche Systeme greifen wiederholt auf Kontext zu, führen Inferenz aus, nutzen Werkzeuge und erzeugen anschließend Antworten. Mehr Rechenleistung allein beseitigt Verzögerungen nicht, wenn der Beschleuniger auf Daten warten muss.
zHBM soll genau diesen Engpass bei Speicherzugriff und Datenübertragung entschärfen. Die Annahme: Liegt HBM näher am Beschleuniger, kann das System schneller reagieren und Daten energieeffizienter bewegen. 1
7 Ob daraus tatsächlich die angekündigten End-to-End-Geschwindigkeitsgewinne entstehen, hängt allerdings vom gesamten System ab – also auch von Beschleuniger, Software, Modell und Packaging, nicht nur von der Platzierung des Speichers.
zNAND-O: eine zusätzliche Kapazitätsstufe
Parallel zu zHBM zeigte Samsung zNAND-O, eine leistungsorientierte NAND-Architektur für datenintensive Anwendungen und Edge-KI. Sie soll eine Ebene zwischen DRAM und herkömmlichem NAND-Flash bilden: mit höherer Dichte als DRAM sowie besserer Ein-/Ausgabe-Leistung, geringerer Latenz und höherer Energieeffizienz als klassischer NAND-Speicher. 49
51
Beide Konzepte bedienen unterschiedliche Ebenen der Speicherhierarchie:
- zHBM ist für die schnellste Speicherebene direkt am KI-Beschleuniger gedacht.
- zNAND-O soll eine dichtere Ebene für Daten und Modelle bereitstellen, deren vollständige Ablage in DRAM teuer wäre.
49
53
Samsung verweist auf einen eigenen Test mit einem GPT-Modell mit 120 Milliarden Parametern. Dabei habe zNAND-O die gleiche Token-Rate wie ein herkömmlicher DRAM-Server erreicht – bei einem Sechstel der Betriebskosten. Das ist ein von Samsung berichtetes Testergebnis und keine allgemeingültige Kostenzusage für den Betrieb großer Modelle. 54
55
Für die längere Sicht bringt Samsung zNAND-O zudem mit sehr großen On-Device-Modellen in Verbindung: KI direkt auf dem Gerät mit Größenordnungen von einer Billion Parametern könnte bis 2030 relevant werden. 53
CXL dürfte HBM bei aktiver KI-Ausführung nicht verdrängen
Die Diskussion auf dem AI Infrastructure Summit verdeutlichte auch: Zusätzliche Kapazität ist wichtig, macht aber nicht jede Speicherart austauschbar. CXL, kurz für Compute Express Link, ist ein Verbindungsstandard, über den Speicher unter anderem erweitert oder gebündelt werden kann.
Daniel Morris, Forscher für KI-Beschleuniger bei OpenAI, sagte, er habe keinen CXL-Anwendungsfall für die tatsächliche Ausführung von KI-Modellen gefunden. Nutzen könne CXL bei selten verwendeten Daten großer Modelle haben. Vidia Thiagarajan von Intel beschrieb CXL-Speicherpooling ebenfalls als Ergänzung zum Sekundärspeicher, nicht als Ersatz für HBM; ausschlaggebend sei die große Bandbreitenlücke zwischen CXL-angebundenem Speicher und HBM. 18
22
Das bedeutet nicht, dass CXL überflüssig wäre. Wahrscheinlicher ist eine gestufte Architektur: lokaler HBM nahe am Beschleuniger für bandbreitenkritische aktive Berechnungen; CXL sowie weitere Speicher- und Storage-Ebenen für kapazitätsorientierte Aufgaben.
Was das für Samsung, SK hynix und den HBM-Markt bedeutet
Kurzfristig entscheidet sich der Wettbewerb bei HBM weiterhin daran, wer Speicher für konkrete Beschleunigerplattformen zuverlässig fertigen, qualifizieren und liefern kann. zHBM verschafft Samsung ein unterscheidbares langfristiges Architekturkonzept. Es ersetzt jedoch nicht den Nachweis bei Ausbeute, Wärmeverhalten, Zuverlässigkeit und Kundenintegration.
Für den HBM-Markt stärkt die Skepsis gegenüber CXL als Ersatz für lokalen HBM die Bedeutung von Speicher direkt am Beschleuniger. Der Wettbewerb dreht sich daher nicht nur um das spektakulärste 3D-Speicherkonzept. Entscheidend ist, wer fortschrittliche Speicher- und Packaging-Technik zuerst in qualifizierte Produkte in hohen Stückzahlen überführen kann. 18
33
36
Fazit
Samsungs Kernbotschaft lautet: Die Leistung von KI wird zunehmend durch Datenbewegung, Speicherkapazität, Energieverbrauch und Wärme begrenzt – nicht allein durch Rechenleistung. zHBM soll diese Engpässe mit einem direkten 3D-Stapel aus Speicher und Beschleuniger angehen; zNAND-O soll eine dichtere, ergänzende Kapazitätsstufe liefern.
Die von Samsung genannten Gewinne sind erheblich, bleiben aber Ziele einer Technologie im Konzeptstadium. Für Betreiber von KI-Infrastruktur ist deshalb vor allem die Richtung relevant: Künftige KI-Systeme dürften auf stärker spezialisierte und vertikal integrierte Speicherhierarchien setzen. HBM bleibt dabei im schnellsten Rechenpfad zentral. 13
14
18
Studio Global AI
Setzen Sie Ihre Recherche fort
Diese Seite enthält eine quellengestützte Antwort, die Sie in Studio Global fortsetzen können.
Die Leute fragen auch
Wie lautet die kurze Antwort auf „Samsung zHBM: HBM direkt auf dem KI-Beschleuniger erklärt“?
Samsung will mit zHBM HBM direkt über einem KI Beschleuniger stapeln und verspricht dadurch mehr als die zehnfache Reaktionsgeschwindigkeit von KI Systemen.
Was sind die wichtigsten Punkte, die zuerst validiert werden müssen?
Samsung will mit zHBM HBM direkt über einem KI Beschleuniger stapeln und verspricht dadurch mehr als die zehnfache Reaktionsgeschwindigkeit von KI Systemen. Für eine künftige zHBM Schnittstelle nennt Samsung als Zielwerte rund das Achtfache der HBM5 Leistung, mehr als die zehnfache Speicherdichte, dreifache Energieeffizienz und über 50 % geringeren Wärmewiderstand.
Was soll ich als nächstes in der Praxis tun?
Fachleute von OpenAI und Intel sehen CXL eher als zusätzliche Kapazitätsstufe für selten genutzte Daten – nicht als Ersatz für HBM bei der aktiven Ausführung von KI Modellen.
Quellen
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push