Warum sich KI-Bilder oft keiner einzelnen Trainingsaufnahme zuordnen lassen
Je größer der Trainingsdatensatz eines Diffusionsmodells ist, desto kleiner kann der kausale Einfluss eines einzelnen Bildes auf eine konkrete Ausgabe werden. Die Forschenden nennen dieses Phänomen „attribution decay“ – eine Abschwächung der Zuordenbarkeit.
Veröffentlicht vonBilder erstellt mit GPT Image 1.5
Je größer der Trainingsdatensatz eines Diffusionsmodells ist, desto kleiner kann der kausale Einfluss eines einzelnen Bildes auf eine konkrete Ausgabe werden.
Die Forschenden nennen dieses Phänomen „attribution decay“ – eine Abschwächung der Zuordenbarkeit.
Dafür entwickelten sie ein Ensemble aus unabhängig trainierten Modellkomponenten, mit dem sich einzelne Trainingsbeispiele gezielt aus einem Gegenfaktum entfernen ließen.
Untersucht wurden 24 Ensembles mit sieben öffentlichen Bilddatensätzen von 256 bis mehr als 160.000 Bildern; die Bildqualität blieb mit der herkömmlicher Diffusionsmodelle vergleichbar.
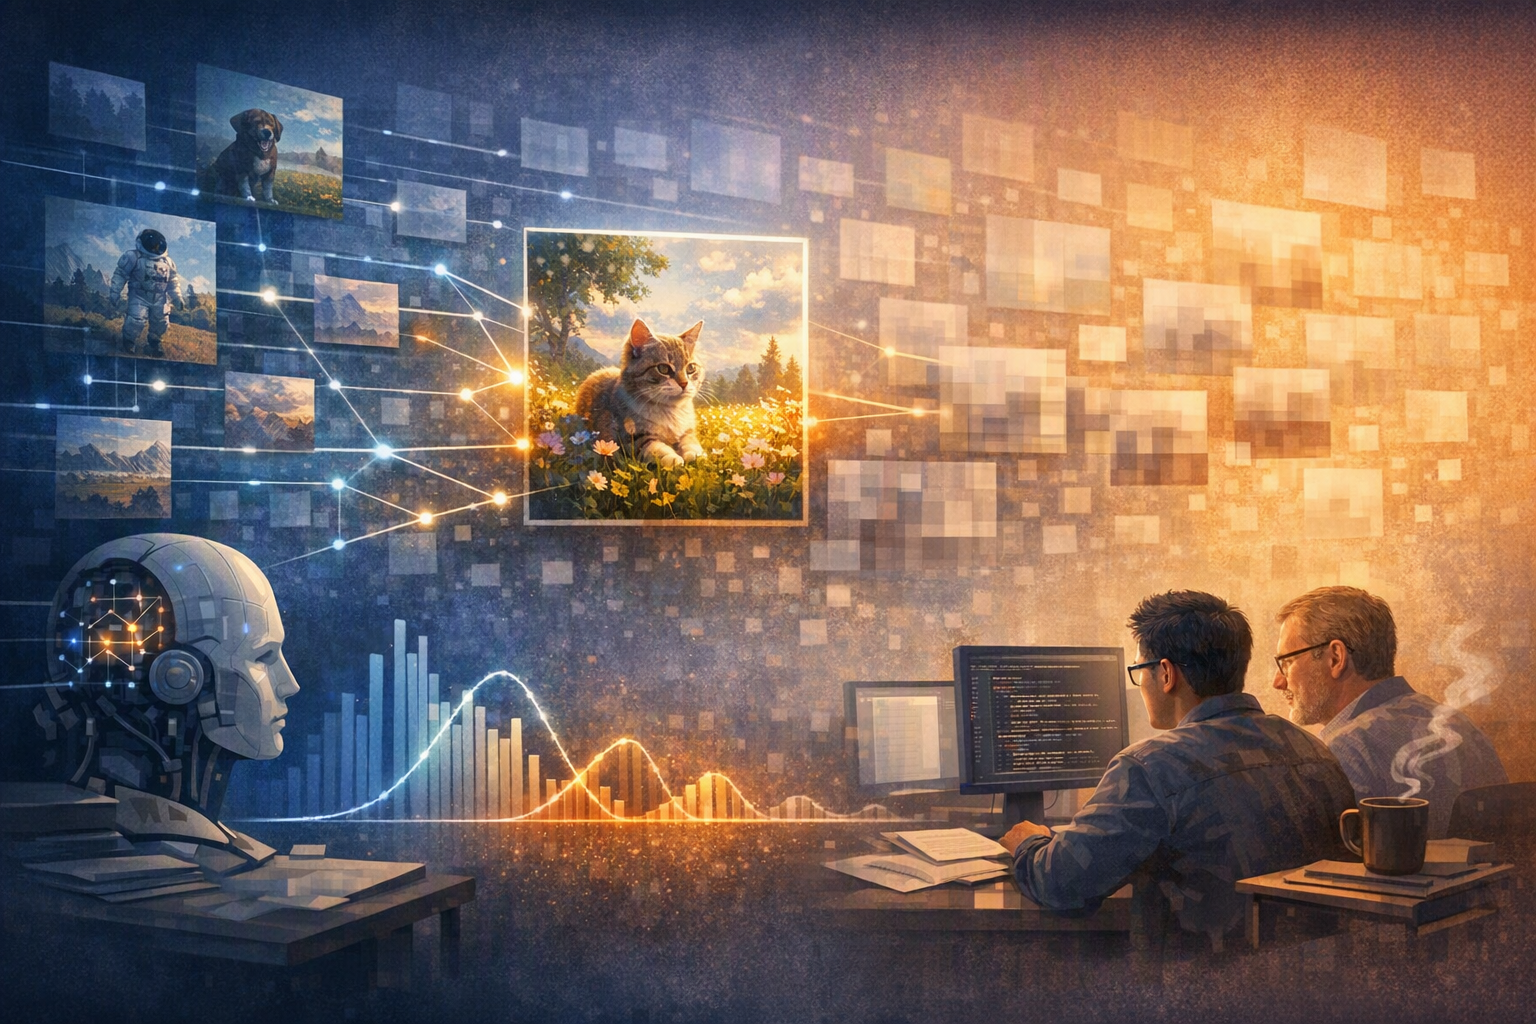
What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusionAI-generated editorial hero image for What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion.
KI-Prompt
Create a landscape editorial hero image for this Studio Global article: What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion. Article summary: Dai and Gifford found “attribution decay”: as a diffusion image generator is trained on more data, the causal effect of any one training item on a particular generated image can shrink until it is too small to detect.. Topic tags: general web, ai safety, openai, chatgpt, llm. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts wit
openai.com
Eine Studie von Zheng Dai und David Gifford vom MIT Computer Science and Artificial Intelligence Laboratory (CSAIL), veröffentlicht in Nature Communications, beschreibt ein kontraintuitives Phänomen bei bildgenerierender KI: Je mehr Trainingsdaten ein Diffusionsmodell verarbeitet, desto weniger lässt sich eine konkrete Ausgabe oft auf ein einzelnes Trainingsbild zurückführen. Die Forschenden nennen diesen Effekt „attribution decay“, also eine Abschwächung der Zuordenbarkeit.
Entscheidend ist die Einschränkung: Die Studie sagt nicht, dass ein Bild nie zum Training verwendet wurde, nicht gespeichert worden sein kann oder nicht unter bestimmten Bedingungen reproduzierbar ausgegeben wird. Sie untersucht vielmehr, ob das Entfernen eines Trainingsbeispiels einen messbaren kausalen Unterschied für eine konkrete Ausgabe macht.
So wurde der Einfluss einzelner Bilder getestet
Üblicherweise lässt sich der Einfluss eines einzelnen Trainingsbildes nur näherungsweise bestimmen. Dai und Gifford entwickelten deshalb ein Diffusions-Ensemble: Mehrere unabhängig trainierte Modellkomponenten sahen jeweils kontrollierte Ausschnitte des Trainingsdatensatzes.
Damit konnten die Forschenden ein präzises Gegenfaktum erzeugen: Was wäre passiert, wenn ein bestimmtes Bild nicht im Training enthalten gewesen wäre? Statt ein großes, einheitliches Modell vollständig neu zu trainieren, deaktivierten sie alle Komponenten, die das fragliche Bild gesehen hatten.
Studio Global AI
Setzen Sie Ihre Recherche fort
Diese Seite enthält eine quellengestützte Antwort, die Sie in Studio Global fortsetzen können.
Wie lautet die kurze Antwort auf „Warum sich KI-Bilder oft keiner einzelnen Trainingsaufnahme zuordnen lassen“?
Je größer der Trainingsdatensatz eines Diffusionsmodells ist, desto kleiner kann der kausale Einfluss eines einzelnen Bildes auf eine konkrete Ausgabe werden.
Was sind die wichtigsten Punkte, die zuerst validiert werden müssen?
Je größer der Trainingsdatensatz eines Diffusionsmodells ist, desto kleiner kann der kausale Einfluss eines einzelnen Bildes auf eine konkrete Ausgabe werden. Die Forschenden nennen dieses Phänomen „attribution decay“ – eine Abschwächung der Zuordenbarkeit.
Was soll ich als nächstes in der Praxis tun?
Dafür entwickelten sie ein Ensemble aus unabhängig trainierten Modellkomponenten, mit dem sich einzelne Trainingsbeispiele gezielt aus einem Gegenfaktum entfernen ließen.
Die Methode wurde in 24 Ensembles mit sieben öffentlichen Bildsammlungen getestet. Die Datensätze umfassten zwischen 256 und mehr als 160.000 Bilder. Für jede Untersuchung erzeugten die Forschenden zunächst ein Bild und anschließend ein ganzes „Gegenfaktum-Universum“ – Versionen, bei denen jeweils eine mögliche Trainingseinheit fehlte.
Als Maß für den größten beobachteten Unterschied verwendeten sie den „counterfactual radius“, also den Gegenfaktum-Radius. Er beschreibt, wie stark sich eine Ausgabe maximal verändert, wenn eine einzelne Trainingseinheit entfernt wird. Zum Vergleich trainierte das Team außerdem 24 herkömmliche Diffusionsmodelle mit denselben Daten. Bei gängigen Bildqualitätsmaßen schnitten die Ensembles ungefähr vergleichbar ab.
Was „attribution decay“ bedeutet
Mit wachsender Datensatzgröße sank der Gegenfaktum-Radius. Das Entfernen eines einzelnen Bildes veränderte die erzeugte Ausgabe zunehmend kaum oder gar nicht mehr. Der kausale Beitrag dieses einen Beispiels wurde damit zu klein, um noch zuverlässig erkennbar zu sein.
Bei ausreichend großen Datensätzen zeigte sich der Effekt laut Studie sogar auf breiteren Ebenen. Das Entfernen sämtlicher Bilder eines bestimmten Künstlers oder aller Fotos, auf denen eine bestimmte Person zu sehen ist, veränderte eine generierte Ausgabe häufig ebenfalls nicht wesentlich.
Das ist ein Ergebnis über Nicht-Zuordenbarkeit im getesteten Gegenfaktum-Sinn: Wenn das Weglassen einer Trainingseinheit die Ausgabe nicht verändert, kann dieser Einheit nach dem Maßstab der Studie keine kausale Verantwortung für genau diese Ausgabe zugeschrieben werden.
Warum das für Urheberrechtsklagen relevant sein könnte
Das Ergebnis könnte eine bestimmte Argumentation in Rechtsstreitigkeiten über Bildgeneratoren erschweren – etwa wenn nachgewiesen werden soll, dass ein konkretes KI-Bild durch die Werke eines bestimmten Künstlers oder durch das Erlernen seines Stils verursacht wurde. Wenn selbst das Entfernen des gesamten Werkkorpus eines Künstlers die Ausgabe praktisch unverändert lässt, kann der direkte, ausgabespezifische kausale Beitrag schwer zu belegen sein.
Eine rechtliche Entscheidung ersetzt die Studie jedoch nicht. In Urheberrechtsverfahren können auch andere Fragen eine Rolle spielen: ob beim Training unbefugt kopiert wurde, wie ähnlich eine konkrete Ausgabe einem geschützten Werk ist, ob das Modell oder der Anbieter Zugang zu den Werken hatte, welcher Marktschaden entstanden ist oder welche vertraglichen Bedingungen galten.
Die wichtigsten Grenzen der Untersuchung
Kein Beweis gegen Memorisierung: Eine Ausgabe kann nach diesem Löschtest keinem einzelnen Trainingsbild zugeordnet werden, obwohl ein Modell Inhalte memoriert, sie unter bestimmten Eingaben oder Zufallsbedingungen reproduzieren kann oder eine geschützte Vorlage auffallend ähnlich nachbildet. Die Studie misst die Empfindlichkeit gegenüber dem Entfernen von Trainingseinheiten – nicht jede Form von Memorisation oder Rechtsverletzung.
Kein Ergebnis über große Sprachmodelle: Untersucht wurden Diffusionsmodelle zur Erzeugung audiovisueller Inhalte. Daraus folgt nicht automatisch, dass derselbe Skalierungseffekt oder die Ensemble-Methode auch für transformerbasierte Large Language Models gilt.
Kein Ersatz für andere Belege: Für technische oder juristische Bewertungen wären weiterhin Prompt- und Reproduktionstests, Ähnlichkeits- und Herkunftsanalysen, Trainingsdaten- und Systemprotokolle, Modellprüfungen sowie die jeweils geltende Rechtslage relevant.
Die Kernaussage lautet daher nicht, dass Kopieren durch KI unnachweisbar sei. Sie lautet enger: Bei sehr großen Trainingsmengen kann die einfache Geschichte „Dieses eine Werk hat dieses eine Ergebnis verursacht“ an Aussagekraft verlieren.
news.mit.edu
Artificial intelligence | Massachusetts Institute of Technology
news.mit.eduWhen AI art has no author: Study finds generated images often can't ...
pmc.ncbi.nlm.nih.govAuthorship Attribution in the Era of LLMs: Problems ... - PMC