ZAYA1‑8B‑Diffusion‑Preview: Zyphra zeigt neuen Weg zu deutlich schnellerer KI‑Textgenerierung
Zyphras ZAYA1‑8B‑Diffusion‑Preview wandelt ein autoregressives Sprachmodell in ein Diffusions‑LLM um, das 16 Tokens parallel erzeugt und laut Entwickler bis zu 7,7× schneller decodieren kann. Die Methode verschiebt Textgenerierung von sequenzieller Token‑für‑Token‑Berechnung zu parallelen Blockoperationen und reduzi...
Veröffentlicht vonBearbeitet mit GPT-5.5Bilder erstellt mit GPT Image 2
Zyphras ZAYA1‑8B‑Diffusion‑Preview wandelt ein autoregressives Sprachmodell in ein Diffusions‑LLM um, das 16 Tokens parallel erzeugt und laut Entwickler bis zu 7,7× schneller decodieren kann.
Die Methode verschiebt Textgenerierung von sequenzieller Token‑für‑Token‑Berechnung zu parallelen Blockoperationen und reduziert damit typische Speicherbandbreiten‑Engpässe bei Inferenz.
Sollten sich die Ergebnisse in realen Anwendungen bestätigen, könnten Inferenzkosten sinken und Reinforcement‑Learning‑Trainings mit vielen Modell‑Rollouts deutlich günstiger werden.
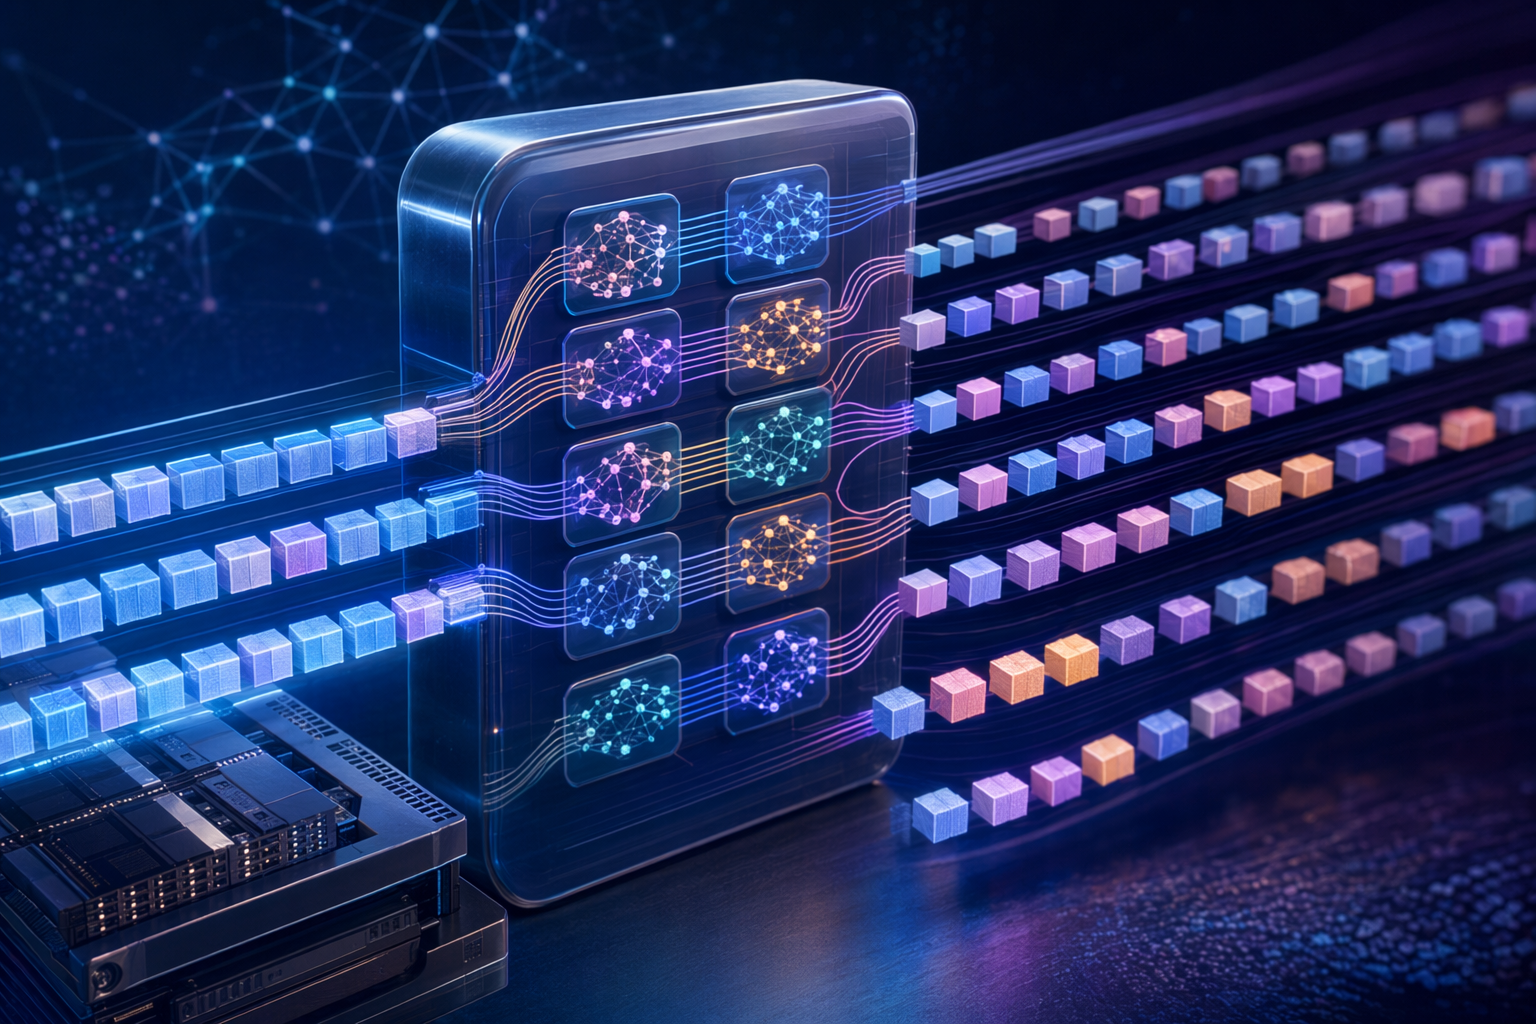
What is Zyphra’s new ZAYA1-8B-Diffusion-Preview model, how does converting its autoregressive ZAYA1-8B into a Mixture-of-Experts diffusion lDiffusion-style language models can draft multiple tokens simultaneously instead of generating them sequentially.
KI-Prompt
Create a landscape editorial hero image for this Studio Global article: What is Zyphra’s new ZAYA1-8B-Diffusion-Preview model, how does converting its autoregressive ZAYA1-8B into a Mixture-of-Experts diffusion l. Article summary: Zyphra’s ZAYA1-8B-Diffusion-Preview is an experimental diffusion-language version of its ZAYA1-8B MoE model, designed to decode blocks of text in parallel rather than strictly one token at a time. Zyphra claims it can ge. Topic tags: general, academic, general web, user generated. Reference image context from search candidates: Reference image 1: visual subject "# Zyphra Releases ZAYA1-8B: A Reasoning MoE Trained on AMD Hardware That Punches Far Above Its Weight Class. Zyphra AI has released ZAYA1-8B, a small Mixture of Experts (MoE) langu" source context "Zyphra Releases ZAYA1-8B: A Reasoning MoE Trained on AMD Hardware That Punches Far Above Its Weight Class
openai.com
Ein neuer Ansatz für schnellere Sprachmodell‑Decodierung
Mit ZAYA1‑8B‑Diffusion‑Preview präsentiert das KI‑Startup Zyphra eine experimentelle Variante seines Sprachmodells ZAYA1‑8B. Statt der üblichen autoregressiven Textgenerierung nutzt das System einen Diffusionsansatz, bei dem mehrere Tokens gleichzeitig vorgeschlagen werden.
Der Unterschied ist entscheidend: Klassische Sprachmodelle erzeugen Text Token für Token. Das Diffusionsmodell hingegen erstellt Blöcke von 16 Tokens pro Schritt. Laut Zyphra kann diese Methode die Decodierung deutlich beschleunigen – theoretisch etwa 4,6× schneller mit einem „lossless“-Sampler und bis zu 7,7× schneller mit einem Logit‑Mixing‑Sampler.
Bemerkenswert ist außerdem, dass das Modell nicht von Grund auf als Diffusionsmodell trainiert wurde. Stattdessen wandelte Zyphra ein vorhandenes autoregressives Modell in einen Diffusions‑Decoder um – ein möglicher Weg, bestehende LLMs nachträglich zu beschleunigen.
Studio Global AI
Setzen Sie Ihre Recherche fort
Diese Seite enthält eine quellengestützte Antwort, die Sie in Studio Global fortsetzen können.
Wie lautet die kurze Antwort auf „ZAYA1‑8B‑Diffusion‑Preview: Zyphra zeigt neuen Weg zu deutlich schnellerer KI‑Textgenerierung“?
Zyphras ZAYA1‑8B‑Diffusion‑Preview wandelt ein autoregressives Sprachmodell in ein Diffusions‑LLM um, das 16 Tokens parallel erzeugt und laut Entwickler bis zu 7,7× schneller decodieren kann.
Was sind die wichtigsten Punkte, die zuerst validiert werden müssen?
Zyphras ZAYA1‑8B‑Diffusion‑Preview wandelt ein autoregressives Sprachmodell in ein Diffusions‑LLM um, das 16 Tokens parallel erzeugt und laut Entwickler bis zu 7,7× schneller decodieren kann. Die Methode verschiebt Textgenerierung von sequenzieller Token‑für‑Token‑Berechnung zu parallelen Blockoperationen und reduziert damit typische Speicherbandbreiten‑Engpässe bei Inferenz.
Was soll ich als nächstes in der Praxis tun?
Sollten sich die Ergebnisse in realen Anwendungen bestätigen, könnten Inferenzkosten sinken und Reinforcement‑Learning‑Trainings mit vielen Modell‑Rollouts deutlich günstiger werden.
Die Diffusions‑Vorschau baut auf ZAYA1‑8B auf, einem Reasoning‑Modell mit Mixture‑of‑Experts‑Architektur (MoE).
Das Modell besitzt insgesamt etwas über 8 Milliarden Parameter, aktiviert während der Inferenz jedoch nur etwa 760 Millionen davon. Diese Architektur soll hohe Leistung ermöglichen, während der Rechenaufwand deutlich geringer bleibt als bei dichten Modellen ähnlicher Größe.
Bei Mixture‑of‑Experts‑Modellen wird für jedes Token nur ein Teil spezialisierter Subnetzwerke („Experten“) genutzt. Dadurch lassen sich Rechenkosten reduzieren, ohne die Modellkapazität stark zu beschneiden.
Warum autoregressive Modelle oft langsam sind
Die meisten heutigen LLMs funktionieren autoregressiv. Jeder neue Token basiert auf allen zuvor erzeugten Tokens.
Typischer Ablauf:
Das Modell generiert den nächsten Token.
Der Token wird im Key‑Value‑Cache gespeichert.
Anschließend beginnt der Prozess für den nächsten Token erneut.
Da jeder Schritt vom vorherigen abhängt, muss die Generierung sequenziell erfolgen. Das erschwert Parallelisierung und führt häufig zu Engpässen bei der Speicherbandbreite, weil der KV‑Cache ständig gelesen und aktualisiert wird.
Wie das Diffusionsmodell 16 Tokens gleichzeitig erzeugt
Bei Zyphras Ansatz verändert sich der Ablauf der Decodierung.
Statt einen einzelnen Token vorherzusagen, erstellt das Modell zunächst mehrere Token‑Entwürfe gleichzeitig. In der aktuellen Vorschau umfasst ein solcher Block 16 Tokens pro Diffusionsschritt.
Der Prozess läuft grob so ab:
Das Modell generiert mehrere mögliche Token‑Entwürfe für einen Block.
Ein Sampler entscheidet, welche Tokens akzeptiert werden.
Die akzeptierten Tokens werden dem Output hinzugefügt, danach beginnt der nächste Block.
Weil alle Kandidaten denselben Kontext und denselben KV‑Cache teilen, kann das Modell mehrere Tokens in einem einzigen Forward‑Pass berechnen. Dadurch verschiebt sich die Arbeit von speicherintensiver Sequenzverarbeitung hin zu stärker parallelisierter GPU‑Berechnung.
Zwei Sampling‑Strategien und ihre Geschwindigkeit
Die gemeldeten Geschwindigkeitsgewinne hängen stark von der Sampling‑Methode ab.
Lossless‑Sampler
Verwendet Regeln ähnlich dem „speculative decoding“.
Laut Zyphra etwa 4,6× schneller als klassische autoregressive Decodierung.
Ziel ist es, keine systematischen Qualitätsverluste zu erzeugen.
Logit‑Mixing‑Sampler
Kombiniert Wahrscheinlichkeitsverteilungen aus Diffusions‑ und autoregressivem Modell.
Erhöht die Akzeptanzrate vorgeschlagener Tokens.
Zyphra berichtet bis zu 7,7× Beschleunigung, allerdings mit möglichem Qualitätsverlust.
Die Ergebnisse stammen derzeit vor allem aus internen Messungen des Unternehmens. Unabhängige Benchmarks werden entscheidend sein, um die tatsächlichen Vorteile im Praxisbetrieb zu bestätigen.
Warum das AMD‑Training auffällt
Ein weiterer ungewöhnlicher Aspekt ist die Hardwarebasis: Zyphra gibt an, dass es sich um das erste Diffusions‑Sprachmodell handelt, das auf AMD‑GPUs trainiert wurde.
Die meisten großen KI‑Modelle werden heute auf Nvidia‑Hardware entwickelt. Ein funktionierender AMD‑basierter Trainings‑ und Inferenz‑Stack könnte zeigen, dass leistungsfähige LLM‑Experimente auch außerhalb des dominierenden Nvidia‑Ökosystems möglich sind.
Sollte sich dieser Ansatz reproduzieren lassen, könnte er langfristig mehr Wettbewerb im Markt für KI‑Beschleuniger fördern.
Compressed Convolutional Attention (CCA)
Das Basismodell nutzt außerdem eine Technik namens Compressed Convolutional Attention (CCA).
Diese Methode soll den Rechenaufwand der Attention‑Berechnung reduzieren, insbesondere bei großen parallelen Operationen.
Das ist für Diffusions‑Decoding relevant, weil die parallele Token‑Erzeugung ähnlich wie eine große „Prefill“-Phase funktioniert. Wenn Attention günstiger wird, lassen sich größere Tokenblöcke effizienter parallel berechnen.
Auswirkungen auf Inferenzkosten
Sollten sich die gemeldeten Beschleunigungen im realen Betrieb bestätigen, hätte das direkte wirtschaftliche Auswirkungen:
mehr erzeugte Tokens pro GPU und Sekunde
geringere Kosten pro generiertem Token
niedrigere Latenz bei langen Antworten
Allerdings weist Zyphra darauf hin, dass Diffusions‑Inference‑Stacks noch weniger optimiert sind als klassische autoregressive Systeme. Der reale Performancegewinn kann daher je nach Anwendung variieren.
Bedeutung für Reinforcement‑Learning‑Training
Viele moderne Reasoning‑Modelle werden mit Reinforcement Learning und sogenannten Rollouts trainiert. Dabei erzeugt das Modell große Mengen an Antwortvarianten.
Je schneller ein Modell Text generieren kann, desto mehr solcher Rollouts lassen sich berechnen. Eine höhere Generationsgeschwindigkeit könnte daher:
In vielen Trainingspipelines gehört Inferenz inzwischen zu den größten Kostenfaktoren.
Ein Hinweis auf die nächste Phase effizienter KI
ZAYA1‑8B‑Diffusion‑Preview steht für einen größeren Trend in der KI‑Entwicklung: Statt ausschließlich immer größere Modelle zu bauen, versuchen Entwickler zunehmend, die Effizienz pro eingesetztem Rechenbudget zu steigern.
Zyphras Ansatz kombiniert mehrere Strategien gleichzeitig:
Mixture‑of‑Experts‑Architektur
Diffusionsbasierte Decodierung
alternative Attention‑Mechanismen
Training auf nicht‑Nvidia‑Hardware
Sollten solche Ansätze skalieren, könnten zukünftige Sprachmodelle nicht nur leistungsfähiger, sondern auch deutlich effizienter bei Durchsatz, Kosten und Hardwareeinsatz werden. Für den Moment zeigt das Projekt vor allem, dass sich bestehende autoregressive Modelle möglicherweise erfolgreich in schnellere Diffusions‑Decoder umwandeln lassen.
zyphra.comZAYA1-8B-Diffusion-Preview: Efficient Parallel Decoding ...
venturebeat.comMeet ZAYA1-8B, a super efficient, open reasoning model trained on ...
gigazine.netA new spreading language model, 'ZAYA1-8B-Diffusion-Preview,' developed with an AMD AI chip, has emerged, transforming autoregressive models into spreading models.
phemex.comZyphra's AMD-Based Diffusion Model Boosts Speed by 7.7x - Phemex