Model Collapse: Warum KI beim Training mit KI‑Daten Realität „vergessen“ kann
Studien zeigen, dass KI‑Modelle bei wiederholtem Training auf synthetischen Daten sogenannte „Model Collapse“ erleiden können – seltene Muster verschwinden aus der Datenverteilung. Rekursives Training verstärkt statistische Verzerrungen: Häufige Muster werden immer dominanter, während seltene Beispiele schrittweise...
Veröffentlicht vonBearbeitet mit GPT-5.5Bilder erstellt mit GPT Image 2
Studien zeigen, dass KI‑Modelle bei wiederholtem Training auf synthetischen Daten sogenannte „Model Collapse“ erleiden können – seltene Muster verschwinden aus der Datenverteilung.
Rekursives Training verstärkt statistische Verzerrungen: Häufige Muster werden immer dominanter, während seltene Beispiele schrittweise verloren gehen.
Analysen deuten darauf hin, dass bereits sehr wenige echte Datenpunkte oder starke Modell‑Priors den Effekt stabilisieren können, indem sie die ursprüngliche Verteilung „verankern“.
What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursiveRecursive training on AI‑generated data can gradually erase rare patterns from a model’s learned distribution, a phenomenon researchers call model collapse.
KI-Prompt
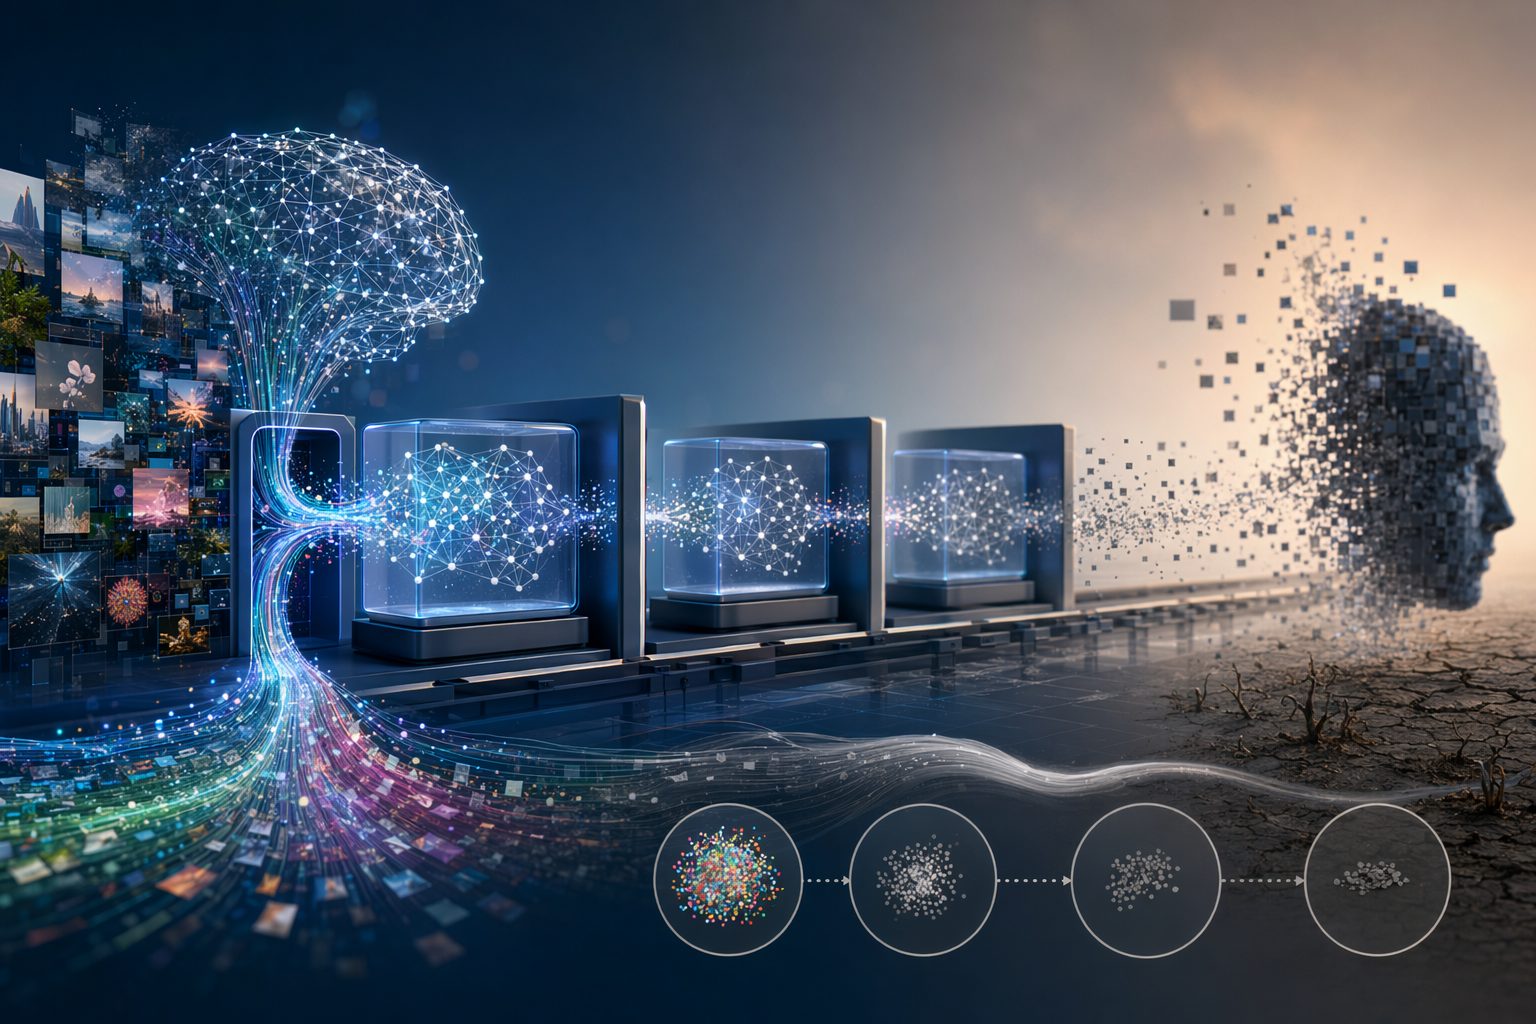
Create a landscape editorial hero image for this Studio Global article: What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursive. Article summary: The study describes model collapse as a failure mode where recursively trained generative models lose information about the original data distribution, especially its rare or low-probability regions.. Topic tags: general, government, education, academic, general web. Reference image context from search candidates: Reference image 1: visual subject "However, as AI-generated data increasingly populates the internet, an important question arises: What happens when new AI models are trained on datasets containing their previous o" source context "Avoiding Model Collapse in AI Training - Risk Insight" Reference image 2: visual subject "Artificial intelligence models
openai.com
Generative KI‑Systeme werden zunehmend mit synthetischen Daten trainiert – also mit Inhalten, die von früheren KI‑Modellen erzeugt wurden. Forschungen zeigen jedoch, dass dieses Vorgehen ein ernstes Risiko birgt: den sogenannten Model Collapse. Dabei verlieren Modelle schrittweise die Fähigkeit, die volle Vielfalt der ursprünglichen Daten abzubilden.
Eine viel zitierte Studie zum rekursiven Training zeigt, dass Modelle, die immer wieder auf KI‑generierten Ausgaben statt auf realen Daten trainiert werden, seltene Muster der ursprünglichen Datenverteilung „vergessen“. Über mehrere Trainingsgenerationen hinweg summiert sich dieser Verlust – bis das Modell ein verzerrtes Bild der Realität lernt.
Studio Global AI
Setzen Sie Ihre Recherche fort
Diese Seite enthält eine quellengestützte Antwort, die Sie in Studio Global fortsetzen können.
Wie lautet die kurze Antwort auf „Model Collapse: Warum KI beim Training mit KI‑Daten Realität „vergessen“ kann“?
Studien zeigen, dass KI‑Modelle bei wiederholtem Training auf synthetischen Daten sogenannte „Model Collapse“ erleiden können – seltene Muster verschwinden aus der Datenverteilung.
Was sind die wichtigsten Punkte, die zuerst validiert werden müssen?
Studien zeigen, dass KI‑Modelle bei wiederholtem Training auf synthetischen Daten sogenannte „Model Collapse“ erleiden können – seltene Muster verschwinden aus der Datenverteilung. Rekursives Training verstärkt statistische Verzerrungen: Häufige Muster werden immer dominanter, während seltene Beispiele schrittweise verloren gehen.
Was soll ich als nächstes in der Praxis tun?
Analysen deuten darauf hin, dass bereits sehr wenige echte Datenpunkte oder starke Modell‑Priors den Effekt stabilisieren können, indem sie die ursprüngliche Verteilung „verankern“.
Da KI‑generierte Inhalte inzwischen in großem Umfang im Internet auftauchen und zukünftige Trainingsdatensätze prägen könnten, wird das Verständnis dieses Effekts zunehmend wichtig.
Was mit „Model Collapse“ gemeint ist
„Model Collapse“ bezeichnet einen Fehlermodus generativer Modelle: Die Qualität und Vielfalt ihrer Ergebnisse nimmt ab, wenn sie überwiegend mit Daten trainiert werden, die von früheren Modellen erzeugt wurden, statt mit originären menschlichen Daten.
Forscher stellten fest, dass rekursives Training irreversible Defekte verursachen kann. Besonders betroffen sind die sogenannten Tails der Datenverteilung – also seltene oder ungewöhnliche Beispiele, die zwar selten auftreten, aber entscheidend sind, um die Realität korrekt abzubilden.
Mit jeder neuen Trainingsgeneration werden die Ausgaben homogener. Das Modell reproduziert immer stärker nur noch die häufigsten Muster der Trainingsdaten.
Der Effekt wurde in mehreren Modelltypen beobachtet, darunter:
Große Sprachmodelle (Large Language Models, LLMs)
Variational Autoencoders (VAEs)
Gaussian Mixture Models (GMMs)
Dass verschiedene Modellfamilien denselben Effekt zeigen, deutet darauf hin, dass Model Collapse kein Spezialfall einzelner Architekturen ist, sondern ein grundsätzliches Problem generativer Lernverfahren bei rekursiven synthetischen Daten.
Warum rekursives Training seltene Muster auslöscht
Der Mechanismus dahinter ist statistisch relativ einfach.
Wenn ein Modell synthetische Daten erzeugt, reproduziert es vor allem wahrscheinliche Muster. Seltene Ereignisse – die in den „Tails“ der Verteilung liegen – werden beim Sampling ohnehin seltener gezogen.
Trainiert man die nächste Modellgeneration auf diesen Daten, passiert Folgendes:
Seltene Beispiele tauchen noch seltener auf.
Das Modell lernt eine leicht verzerrte Datenverteilung.
Jede weitere Generation verstärkt diese Verzerrung.
So entsteht ein Feedback‑Effekt: Kleine Sampling‑Fehler aus früheren Modellen werden immer stärker verstärkt. Irgendwann verschwinden die seltenen Muster vollständig aus den Trainingsdaten.
Sobald diese Beispiele im Datensatz fehlen, können spätere Modelle sie nicht mehr rekonstruieren – weil der Hinweis darauf, dass sie überhaupt existierten, verloren gegangen ist.
Wie reale Daten oder Vorwissen den Kollaps verhindern können
Ein überraschendes Ergebnis aus neueren Analysen ist, wie wenig reale Information möglicherweise nötig ist, um diesen Effekt zu stoppen.
In Untersuchungen zu statistischen Modellklassen, den sogenannten exponentiellen Familien, zeigte sich: Schon ein einzelner Datenpunkt aus der echten Verteilung kann den Trainingsprozess stabilisieren. Dieser Datenpunkt liefert den Beweis, dass bestimmte Muster existieren – und verhindert, dass das rekursive Training auf eine falsche Verteilung konvergiert.
Ähnlich kann auch Vorwissen (Priors) helfen. Wenn Modelle bestimmte strukturelle Annahmen oder Einschränkungen enthalten, begrenzen diese den Raum möglicher Verteilungen und verhindern, dass das Modell vollständig in Richtung der verzerrten synthetischen Daten driftet.
Praktisch bedeutet das:
Echte Daten bewahren seltene, aber valide Muster.
Priors geben dem Modell strukturelle Leitplanken.
Selbst wenn synthetische Daten den Großteil eines Datensatzes ausmachen, können solche „Anker“ das Training stabilisieren.
Warum das für große Sprachmodelle wichtig ist
Das Problem gewinnt an Bedeutung, weil KI‑generierte Inhalte im Netz rapide zunehmen.
Große Sprachmodelle werden häufig mit riesigen Internet‑Datensätzen trainiert. Wenn jedoch immer mehr dieser Texte bereits von KI stammen, könnten zukünftige Trainingskorpora zunehmend synthetisch kontaminiert sein.
Werden neue Modelle hauptsächlich auf solchen Daten trainiert, könnten sie sich allmählich von der Vielfalt menschlicher Sprache und des realen Wissens entfernen.
Mögliche Folgen wären etwa:
geringere Vielfalt in generierten Antworten
schlechtere Verarbeitung ungewöhnlicher oder seltener Fälle
eine zunehmend verengte Darstellung realer Informationen
Forscher betonen daher, dass langfristig verlässliche menschliche Datenquellen oder robuste Trainingsmechanismen nötig sind, um die ursprüngliche Datenverteilung zu bewahren.
Grenzen der bisherigen Erkenntnisse
Der grundlegende Mechanismus von Model Collapse ist gut belegt, doch einige Details sind noch offen.
So stammt die Aussage, dass ein einzelner realer Datenpunkt ausreichen könnte, vor allem aus theoretischen Analysen und vereinfachten statistischen Modellen – nicht aus großskaligen Trainingsläufen moderner Sprachmodelle.
Wie viele echte Daten in der Praxis nötig sind, kann daher je nach Modellarchitektur, Datensatz und Trainingsverfahren variieren.
Trotzdem ist die zentrale Erkenntnis klar: Rein rekursives KI‑Training kann Teile der Realität aus Modellen verschwinden lassen. Eine dauerhafte Verbindung zu echten Daten bleibt entscheidend, damit KI‑Systeme langfristig zuverlässig bleiben.
arxiv.org
Lost in Retraining: Roaming the Parameter Space of ...
pmc.ncbi.nlm.nih.govAI models collapse when trained on recursively generated data - PMC
pure.ed.ac.uk[PDF] AI models collapse when trained on recursively generated data
openreview.net[PDF] How Bad is Training on Synthetic Data? A Statistical Analysis of ...
techxplore.comA single real-world data point may stop AI model collapse, analysis suggests