AntwortenVeröffentlicht16 Quellen
Ein gemeinsamer Kern für acht Programmiersprachen – mit klaren Grenzen
Der Vorschlag trennt sprachspezifische Adapter von einem gemeinsamen Modell für Dateien, Deklarationen, Abhängigkeiten und Belege. Als harte Obergrenze sind 24.576 Byte pro ausgeliefertem Frame vorgesehen.
Veröffentlicht vonBilder erstellt mit GPT Image 2
Forschungsantwort
Wichtige Erkenntnisse
- Der Vorschlag trennt sprachspezifische Adapter von einem gemeinsamen Modell für Dateien, Deklarationen, Abhängigkeiten und Belege.
- Als harte Obergrenze sind 24.576 Byte pro ausgeliefertem Frame vorgesehen. Sind die notwendigen Informationen zu groß, soll das System abbrechen statt sie stillschweigend wegzulassen.
- Ein historischer Python Testfall lieferte einen Kern Frame von 18.869 Byte. Dabei blieben jedoch 751 erkannte Aufrufausdrücke außen vor – das Ergebnis war also keine vollständige Programmbeschreibung.
- Tree sitter kann die Syntaxstruktur liefern, ersetzt aber keinen Compiler und beweist weder Typkorrektheit noch Laufzeitverhalten.
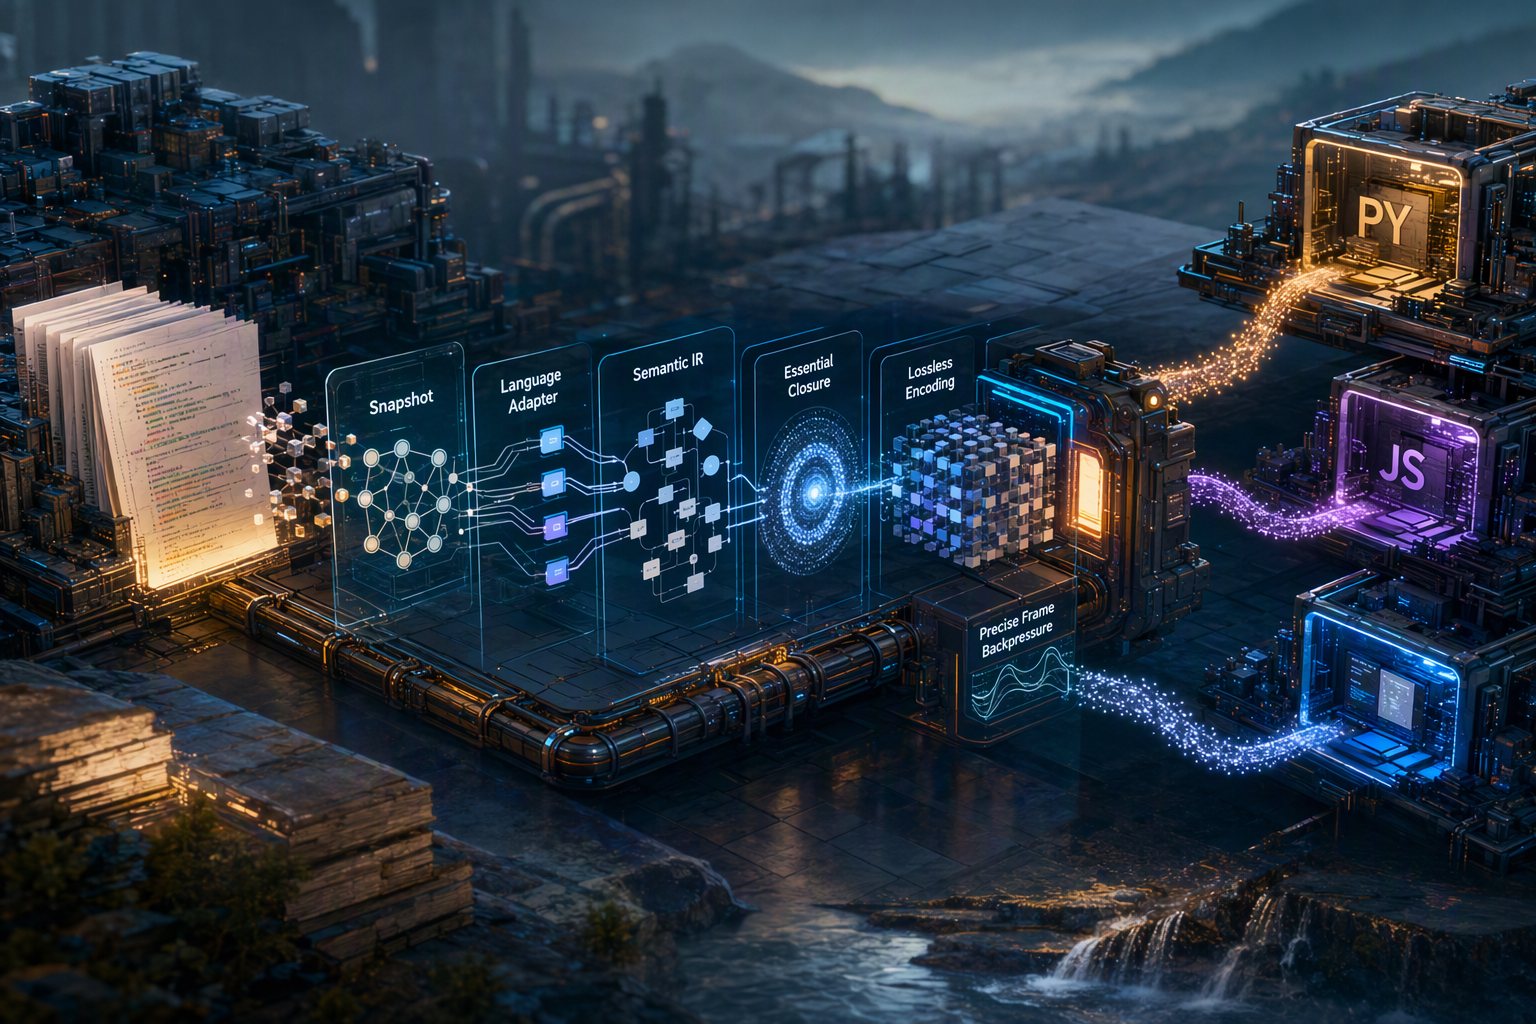
KI-Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
Ein gemeinsamer Analyse-Kern für acht Sprachen klingt nach einer einfachen Gleichung: Quellcode einlesen, wichtige Informationen extrahieren, überflüssige Wiederholungen komprimieren – und alles unter ein festes Größenlimit bringen. Der Architekturvorschlag für TypeScript, Java, C#, Python, Rust, Go, C und C++ setzt genau dort an. Seine entscheidende Einschränkung ist aber ebenso wichtig wie der technische Plan: Ein Frame von höchstens 24.576 Byte kann nur dann vollständig sein, wenn die tatsächlich erforderlichen Informationen hineinpassen.
Der RFC ist als Entwurf zu verstehen. Er beschreibt eine mögliche Architektur und einen Prüfplan, nicht eine bereits fertige Mehrsprachen-Implementierung. Die vorliegenden historischen Python-Ergebnisse sind Hinweise auf einen bestehenden Kern, aber kein Beleg dafür, dass alle acht Sprachen funktionieren oder beliebig große Projekte in ein einziges Paket passen.
Ein gemeinsames Modell statt acht separater Pipelines
Der Vorschlag teilt die Arbeit in klar abgegrenzte Schichten: Ein berechtigter Leser erstellt zunächst einen unveränderlichen Snapshot der Quelldateien. Danach übernimmt ein sprachspezifischer Adapter die Syntax und bildet erkannte Fakten auf ein gemeinsames semantisches Modell ab. Ein generischer Kern prüft anschließend, welche Informationen unverzichtbar sind, baut deren Abhängigkeiten auf, kodiert den ausgewählten Inhalt und misst die vollständige Ausgabe. Ein unabhängiger Verbraucher soll das Ergebnis schließlich dekodieren und gegen die Quellen prüfen.
Das Modell soll vier grundlegende Arten von Knoten kennen: Pakete oder Namensräume, Module oder Dateien, Vertragsdeklarationen wie Typen und Schnittstellen sowie aufrufbare Deklarationen wie Funktionen und Methoden. Beziehungen werden unter anderem als Abhängigkeiten, Implementierungen, Aufrufe und Vererbung abgebildet. Dabei gilt eine wichtige Trennung: Ein im Quelltext sichtbarer Verweis belegt nicht automatisch, dass ein Compiler ihn akzeptiert oder dass der betreffende Aufruf zur Laufzeit tatsächlich erfolgt.
Zu jedem Eintrag sollen außerdem Belege, Quellbereiche, Bedingungen und ein Status gehören. So kann das System etwa festhalten, dass ein Zusammenhang statisch erkannt wurde, nur unter einer bestimmten Bedingung gilt oder ungeklärt bleibt. Unbekanntes soll ausdrücklich unbekannt bleiben – statt durch eine plausible Vermutung ersetzt zu werden.
Syntax ist noch kein vollständiges Programmverständnis
Als mögliche gemeinsame Parsing-Grundlage nennt der Entwurf Tree-sitter. Die Bibliothek erzeugt einen konkreten Syntaxbaum und unterstützt Abfragen auf dessen Knoten. Das macht sie zu einer Grundlage für strukturelle Analyse, aber nicht zu einem Ersatz für Compiler, Typprüfer oder Laufzeitumgebung. 11
16
Das ist für den Anspruch „sprachunabhängig“ zentral. Ein generischer Kern kann sprachunabhängig arbeiten, wenn er bereits geprüfte Knoten, Beziehungen und Bedingungen erhält. Die Bedeutung von Exporten, Zugriffsregeln, Makros, bedingter Kompilierung oder dynamischen Aufrufen muss jedoch weiterhin der jeweilige Adapter beurteilen.
Auch die Sichtbarkeit einer Deklaration lässt sich nicht überall auf ein einfaches „öffentlich“ oder „privat“ reduzieren. Bei TypeScript sind etwa Typ- und Wertebene zu unterscheiden; außerdem ist ein Modul-Export nicht automatisch gleichbedeutend mit einem für Paketnutzer erreichbaren Einstiegspunkt. 3
7
8 In anderen Sprachen kommen jeweils eigene Regeln für Pakete, Namensräume, Module oder bedingte Deklarationen hinzu. Der RFC markiert diese Regeln teilweise ausdrücklich als noch zu verifizierende Adapterpolitik – und damit als Arbeit vor einer Produktionsfreigabe.
Tree-sitter bringt zudem eine eigene Kompatibilitätsfrage mit: Die Sprachkomponenten müssen zur verwendeten Laufzeit und deren ABI passen. Der Entwurf verlangt deshalb, Versionen und Plattformpakete zu prüfen, statt allein auf einen erfolgreichen Download zu vertrauen. 13
Was der historische Größenwert tatsächlich aussagt
Ein früherer Beleg dokumentiert für einen Python-Snapshot aus fünf Dateien einen Kern-Frame von 18.869 Byte. Der zugehörige Datensatz umfasste 79 Importe, 84 Definitionen und 79 statische Abhängigkeitsverweise. Das ist ein konkreter Messwert für diesen Fall – aber keine allgemeine Untergrenze, keine Garantie für künftige Projekte und kein Beleg dafür, dass sämtliche Programmsemantik enthalten war.
Denn im selben Ergebnis wurden 751 erkannte Aufrufausdrücke ausgelassen: 16 aus einer mittleren und 735 aus einer niedrigeren Prioritätsstufe. Der Beleg kennzeichnete die Ausgabe damit als teilweise Lieferung. Eine gezielte Regression mit 40 Tests wurde damals als erfolgreich protokolliert; auch das ist ein historisches Ergebnis und keine erneute Prüfung im Rahmen des RFC. Eine weitere Dokumentation nennt 205 bestandene Offline-Tests, doch auch diese Zahl wurde für den Entwurf nicht neu ausgeführt.
Hinzu kommt eine inhaltliche Grenze des bestehenden Python-Extraktors: Die belegte Logik erfasst Namen, qualifizierte Namen, Kategorien und Basisklassen, reicht aber nicht aus, um vollständige Signaturen, Standardwerte, Rückgabetypen und Generikbedingungen als bereits abgedeckt anzunehmen. Ebenso ist ein vorhandener Rauchtest nicht automatisch ein unabhängiger Prüfer, wenn er denselben Produktionsdecoder verwendet.
Pflichtwissen zuerst – und kein stilles Wegkürzen
Der Kern des Vorschlags ist eine geschichtete Auswahl. Notwendige Importe und Deklarationen bilden den Pflichtbereich. Weitere Informationen können hinzukommen, solange dadurch keine Pflichtinformation verdrängt wird. Für die Kompatibilität soll eine bestehende Politik, die alle bisherigen Definitionen schützt, erhalten bleiben. Eine neue Politik für ausgewählte öffentliche Verträge müsste ausdrücklich aktiviert werden; sie darf nicht unbemerkt Methoden oder verschachtelte Definitionen aus der Pflichtmenge entfernen.
Kompression und Wiederverwendung von Symbolen können doppelte Pfade, Namen oder Bedingungen einsparen. Sie können jedoch keine beliebig großen, voneinander unabhängigen Signaturen in ein endliches Paket zaubern. Der Entwurf zieht daraus die passende Konsequenz: Passt der vollständige Pflichtkern nicht in die erlaubte Größe, muss das Ergebnis blockiert werden. Alternativen wie Aufteilung in mehrere Frames wären eine gesondert zu genehmigende Änderung – und wären nicht mehr die Behauptung, alle Informationen steckten in einem einzelnen Frame.
Auch das Größenlimit muss präzise verstanden werden. Gemessen werden soll der vollständige ausgelieferte Frame, nicht nur die inneren Datensätze. Dazu zählen auch Protokollhülle, Kennungen, Diagnosen, Escaping und abschließende Zeilenumbrüche. Der RFC setzt für neue Lieferungen eine physische Obergrenze von 24.576 Byte an. Zugleich soll die bestehende Grenze des V2-A-Modus von 22.016 Byte unverändert bleiben: Der neue Vorschlag ist keine automatische Erlaubnis, alte Limits anzuheben.
Für die Rücksteuerung sieht der Entwurf begrenzte Zustände vor: eine vollständige Ausgabe, einen vollständigen Pflichtkern mit ausdrücklich ausgelassenen optionalen Inhalten, eine klar ausgewiesene Budgetüberschreitung oder einen Abbruch bei fehlenden Quellen, Parsingfehlern oder anderen Hindernissen. Nur ein echter Budgetengpass soll einen erneuten Versuch mit angepasstem, weiterhin autorisiertem Limit auslösen. Fehlende Belege dürfen nicht als Größenproblem kaschiert werden.
Was in den Sprachtests noch belegt werden muss
Als vorgeschlagene Prüfprojekte nennt der RFC Redux für TypeScript, Spring Framework für Java, HTTP-Abstraktionen aus ASP.NET Core für C#, den bereits betrachteten FastCode-Bereich für Python, ripgrep für Rust, Gin für Go, Redis für C und fmt für C++. Die Auswahl ist ein Testplan, keine Bestätigung, dass die Projekte bereits eingefroren, ausgewertet oder erfolgreich analysiert wurden.
Vor Messungen sollen Dateimengen, Quellenstände, Deklarationen, Bedingungen und unabhängige Erwartungen festgelegt werden. Entscheidend ist nicht nur, ob der Parser irgendetwas findet: Pflichtdeklarationen und Abhängigkeiten müssen vollständig erfasst, Signaturen und Quellenbereiche erhalten und Beziehungen korrekt oder ausdrücklich ungeklärt markiert werden. Jeder ausgelieferte Frame muss unter dem wirksamen Limit liegen. Fehlerhafte oder unvollständige Pflichtdaten dürfen keinen erfolgreichen Abschluss erzeugen.
Der Plan ist in vier Etappen angelegt: zuerst ein Python-Adapter mit Schutz der bisherigen Schnittstellen, dann TypeScript und Go, anschließend Java und C# und zuletzt Rust, C und C++. Für jede Etappe sind eigenständige Positiv- und Negativtests vorgesehen. Insbesondere dürfen Adapter, Encoder und Prüfer nicht dieselbe Logik als einzige Wahrheitsquelle teilen – sonst besteht die Gefahr, dass ein Fehler bei der Extraktion von derselben fehlerhaften Logik bestätigt wird.
Das belastbare Versprechen ist enger – und nützlicher
Der Architekturvorschlag verspricht nicht, jede Sprache vollständig zu verstehen oder beliebige Repositories ohne Verluste in 24.576 Byte zu pressen. Er skizziert stattdessen ein überprüfbares Ziel: Für einen klar definierten Umfang sollen alle notwendigen statischen Informationen samt Belegen erhalten bleiben; optionale Auslassungen und unbekannte Fälle sollen sichtbar sein; und ein Ergebnis, das die harte Grenze überschreitet, soll nicht als vollständig ausgegeben werden.
Das ist eine realistischere Grundlage für ein industrielles System als ein pauschales Versprechen von „verlustfreier“ Analyse. Bevor der RFC als Produktionsstandard gelten kann, müssen unter anderem die Sprachregeln und Parserpakete verifiziert, die unabhängige Prüfung aufgebaut und die acht festgelegten Testbestände tatsächlich gemessen werden. Bis dahin ist die Architektur ein bedingter, sorgfältig abgegrenzter Plan – kein Nachweis für bereits erreichte Mehrsprachen-Abdeckung.
Studio Global AI
Setzen Sie Ihre Recherche fort
Diese Seite enthält eine quellengestützte Antwort, die Sie in Studio Global fortsetzen können.
Die Leute fragen auch
Wie lautet die kurze Antwort auf „Ein gemeinsamer Kern für acht Programmiersprachen – mit klaren Grenzen“?
Der Vorschlag trennt sprachspezifische Adapter von einem gemeinsamen Modell für Dateien, Deklarationen, Abhängigkeiten und Belege.
Was sind die wichtigsten Punkte, die zuerst validiert werden müssen?
Der Vorschlag trennt sprachspezifische Adapter von einem gemeinsamen Modell für Dateien, Deklarationen, Abhängigkeiten und Belege. Als harte Obergrenze sind 24.576 Byte pro ausgeliefertem Frame vorgesehen. Sind die notwendigen Informationen zu groß, soll das System abbrechen statt sie stillschweigend wegzulassen.
Was soll ich als nächstes in der Praxis tun?
Ein historischer Python Testfall lieferte einen Kern Frame von 18.869 Byte. Dabei blieben jedoch 751 erkannte Aufrufausdrücke außen vor – das Ergebnis war also keine vollständige Programmbeschreibung.