AnswersPublished24 sources
AI-kapløbet har en brutal bagside: Bøger blev skåret op, scannet og makuleret
Anthropic gennemførte fra begyndelsen af 2024 Project Panama, hvor selskabet for titusinder af millioner dollar købte, destruktivt scannede og ødelagde millioner af bøger for at træne Claude [2][3][8][9]. Antikvarboghandleren Pieter de Vries i Haarlem modtog en forespørgsel fra Singapore firmaet 2077AI med en liste...
Udgivet afRedigeret med DeepSeek-V4-FlashBilleder genereret med GPT Image 1.5
Research answer
Key takeaways
- Anthropic gennemførte fra begyndelsen af 2024 Project Panama, hvor selskabet for titusinder af millioner dollar købte, destruktivt scannede og ødelagde millioner af bøger for at træne Claude [2][3][8][9].
- Antikvarboghandleren Pieter de Vries i Haarlem modtog en forespørgsel fra Singapore firmaet 2077AI med en liste på over 3.000 ISBN numre – primært smalle akademiske titler [5][6][7][8].
- En amerikansk dommer fandt, at lovligt købte bøger kunne scannes til AI træning som fair use, men ikke at piratkopierede bøger var omfattet.
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What are the key details about AI companies' practice of "destructive scanning"—secretly purchasing millions of physical books through anony. Article summary: I'll research each of these claims. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clickbait thumbnails, icons, and tiny thumbnail layouts. Make it useful as an illustrative visual, not as factual evidence.
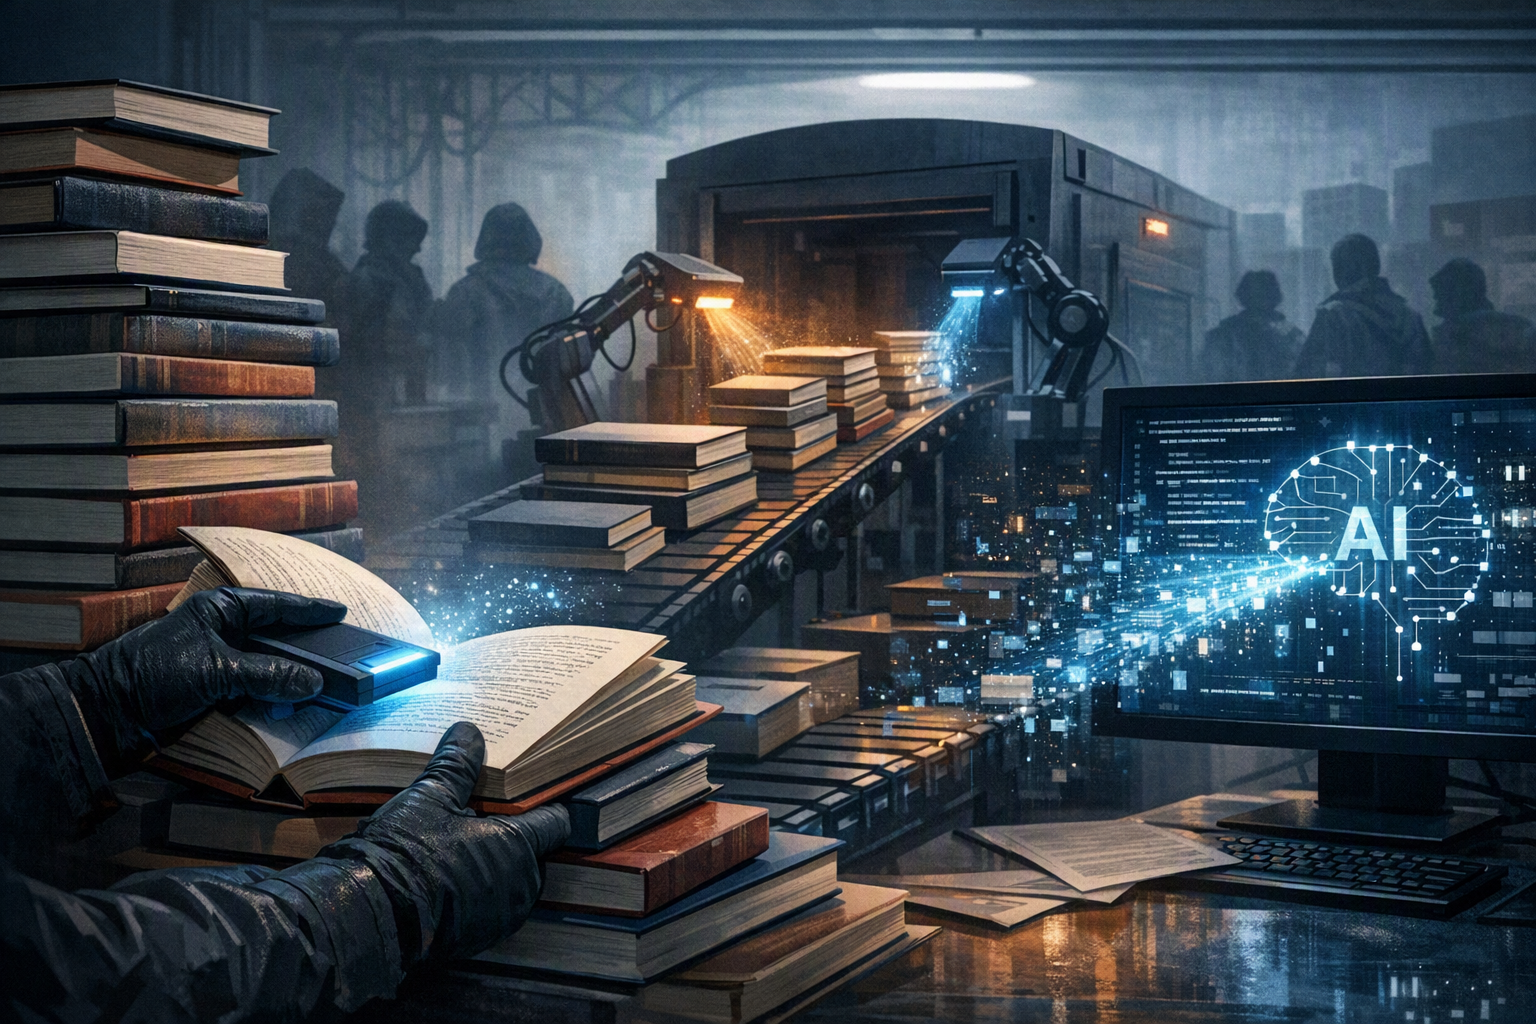
Kapløbet om at bygge stadig bedre sprogmodeller har skabt en opsigtsvækkende efterspørgsel efter fysiske bøger. I stedet for at ende på en reol bliver nogle af dem købt i store partier, skåret op med hydrauliske maskiner, scannet side for side og til sidst makuleret.
Metoden kaldes destruktiv scanning. Den er blevet beskrevet i undersøgende journalistik og i retsdokumenter, der blev offentliggjort i forbindelse med ophavsretssagen Bartz v. Anthropic.
Hvad er destruktiv scanning?
AI-virksomheder og deres mellemled køber fysiske bøger i store mængder – også sjældne og udsolgte titler. Bøgerne går derefter gennem en industriel proces:
- Ryggen skæres af med en hydraulisk skæremaskine.
- De løse sider føres gennem højhastighedsscannere.
- Papirresterne makuleres eller sendes til genanvendelse .
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "AI-kapløbet har en brutal bagside: Bøger blev skåret op, scannet og makuleret"?
Anthropic gennemførte fra begyndelsen af 2024 Project Panama, hvor selskabet for titusinder af millioner dollar købte, destruktivt scannede og ødelagde millioner af bøger for at træne Claude [2][3][8][9].
What are the key points to validate first?
Anthropic gennemførte fra begyndelsen af 2024 Project Panama, hvor selskabet for titusinder af millioner dollar købte, destruktivt scannede og ødelagde millioner af bøger for at træne Claude [2][3][8][9]. Antikvarboghandleren Pieter de Vries i Haarlem modtog en forespørgsel fra Singapore firmaet 2077AI med en liste på over 3.000 ISBN numre – primært smalle akademiske titler [5][6][7][8].
What should I do next in practice?
En amerikansk dommer fandt, at lovligt købte bøger kunne scannes til AI træning som fair use, men ikke at piratkopierede bøger var omfattet.
Sources
dallasexpress.comAI Firms Scan Then Destroy Rare Book Editions
emeraldbook.orgWhy AI Companies Are Destroying Original Literature to Train ...
news.com.auAI labs buy, scan, shred millions of rare books
christianactivities.comThe Hidden Costs of Destroying Physical Books for AI Training Data | Christian Activities
