AnswersPublished26 sources
Samsung zHBM: proč by paměť přímo na AI akcelerátoru mohla změnit výkon AI
Samsung tvrdí, že zHBM může zvýšit rychlost odezvy AI systémů více než desetinásobně, protože HBM umisťuje přímo nad AI akcelerátor, nikoli vedle něj. Pro rozhraní využívající zHBM firma uvádí cíl přibližně 8× vyššího výkonu než u HBM5, více než 10× vyšší hustoty paměti, 3× lepší energetické efektivity a více než o...
PublikovalUpraveno pomocí GPT-5.6 TerraObrázky vytvořeny pomocí GPT Image 2
Research answer
Key takeaways
- Samsung tvrdí, že zHBM může zvýšit rychlost odezvy AI systémů více než desetinásobně, protože HBM umisťuje přímo nad AI akcelerátor, nikoli vedle něj.
- Pro rozhraní využívající zHBM firma uvádí cíl přibližně 8× vyššího výkonu než u HBM5, více než 10× vyšší hustoty paměti, 3× lepší energetické efektivity a více než o polovinu nižšího tepelného odporu.
- Inženýři z OpenAI a Intelu na stejném summitu zpochybnili, že by CXL mohlo při aktivním běhu AI modelů nahradit HBM; spíše jej vidí jako doplňkovou kapacitní vrstvu.
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
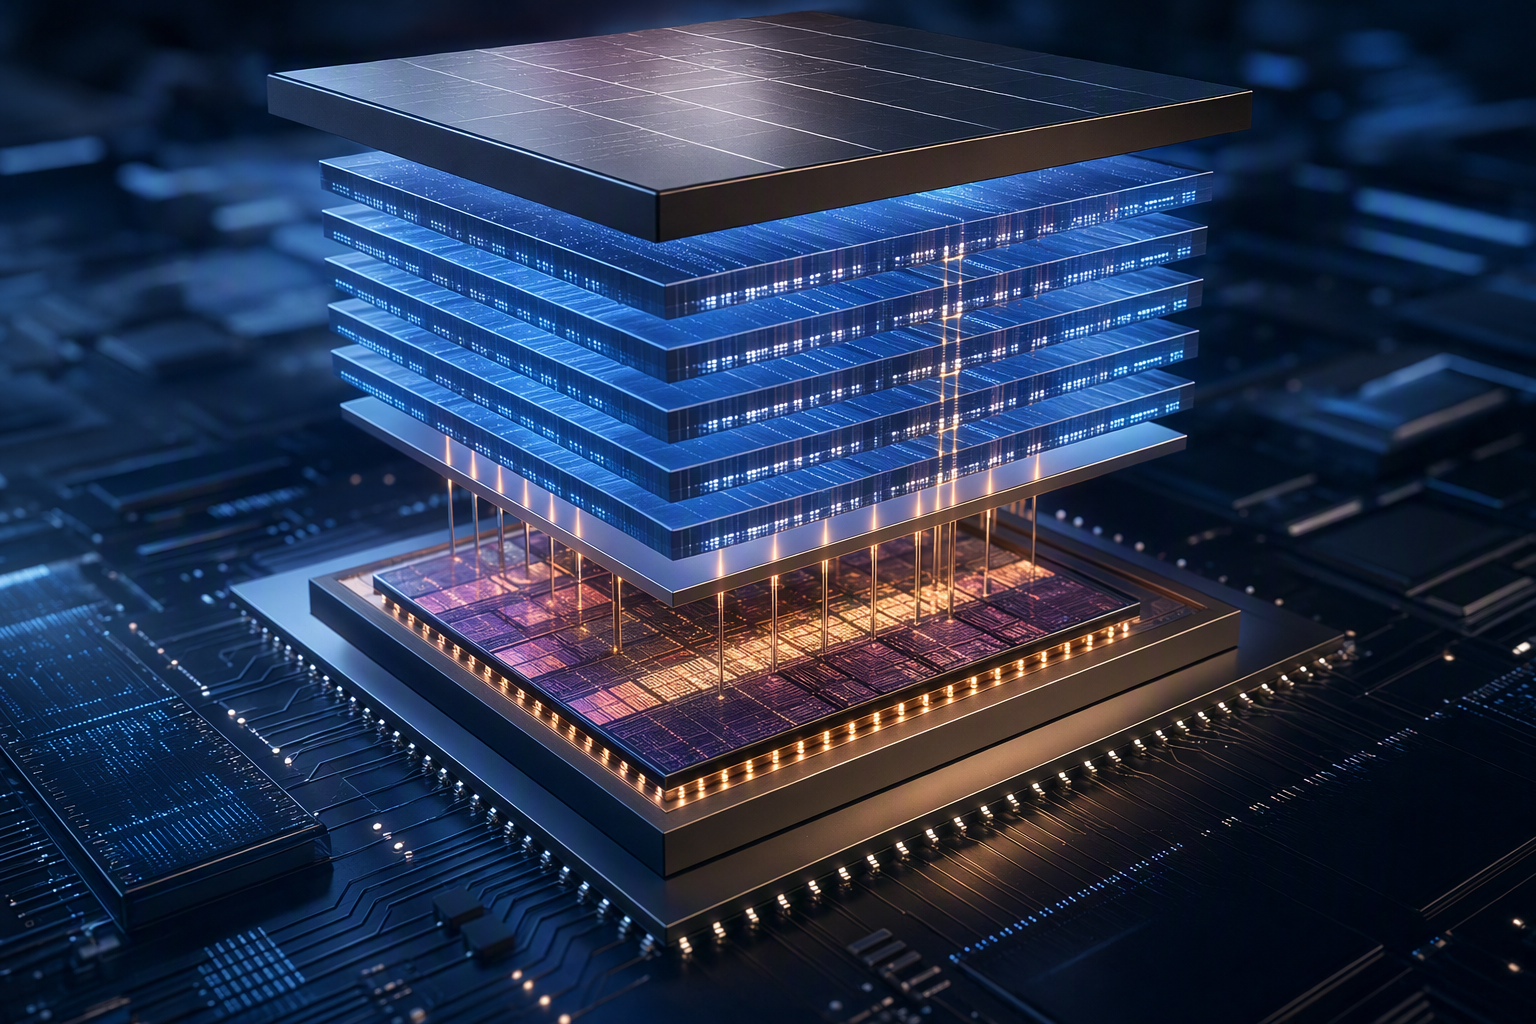
Samsung navrhuje se zHBM zkrátit fyzickou vzdálenost mezi AI výpočtem a jeho nejrychlejší pamětí. Místo umístění paměti s vysokou propustností (HBM) vedle GPU či jiného akcelerátoru by ji umístil přímo nad procesor v trojrozměrném pouzdře. Na summitu AI Infrastructure Summit 16. září v kalifornské Santa Claře firma tento přístup představila jako cestu k pohotovějším systémům agentní AI. 1
9
V čem se zHBM liší od dnešního řešení?
V běžném uspořádání je HBM vedle akcelerátoru ve stejné rovině a čipy propojuje pokročilé pouzdření. Koncept zHBM naopak skládá HBM vertikálně přímo nad AI akcelerátor. Samsung tak chce v 3D přiblížit logiku a paměť k sobě. 12
13
Princip je jednoduchý: kratší cesta pro data by měla zvýšit propustnost a energetickou efektivitu a zároveň umožnit vměstnat více paměti do stejné plochy. Vertikální integraci má umožnit nová generace spojování waferů, včetně hybridního měděného bondingu. 7
48
Nejde však o náhradu všech současných HBM pouzder, která by byla hned k dispozici. Samsung zHBM ukázal jako konceptní model a termín komerčního nasazení neoznámil. 13
14
Co Samsung slibuje — a co zatím nevíme
Samsung pro rozhraní nové generace využívající zHBM uvádí ambiciózní cíle:
- přibližně 8× vyšší výkon než HBM5,
- více než 10× vyšší hustotu paměti proti konvenční HBM5,
- zhruba 3× lepší energetickou efektivitu,
- více než o 50 % nižší tepelný odpor.
13
48
Na AI Infrastructure Summitu firma také uvedla, že by zHBM mohlo zrychlit odezvu AI systémů více než desetinásobně; dlouhodobým cílem je 1 000 tokenů za sekundu. Token je zjednodušeně jednotka textu, kterou generativní model při práci zpracovává nebo vytváří. 1
9
Tato čísla je ale vhodné číst jako cíle společnosti pro budoucí architekturu, nikoli jako nezávisle ověřené výsledky hotového komerčního akcelerátoru. Přímé vrstvení paměti nad logiku musí obstát ve výrobní výtěžnosti, chlazení, spolehlivosti i kvalifikaci u partnerů vyrábějících akcelerátory.
Proč je to důležité pro agentní AI
Samsung zHBM zasadil do kontextu AI agentů. Ty opakovaně čtou kontext, provádějí inferenci, používají nástroje a vytvářejí další výstupy. Ani vysoký výpočetní výkon sám o sobě nepomůže, pokud akcelerátor čeká na přesun dat.
zHBM má mířit právě na toto úzké hrdlo paměti a datových přenosů. Záměrem je, aby bližší HBM zvýšila pohotovost systému a současně snížila energii nutnou k přesunu dat. 1
7 Zda se to promítne do deklarovaného zrychlení celé odezvy, bude záviset na kompletním návrhu akcelerátoru, softwaru, modelu i pouzdra — nikoli jen na poloze paměti.
zNAND-O jako doplněk pro kapacitu
Vedle zHBM Samsung představil zNAND-O, vysoce výkonnou NAND architekturu pro datově náročná prostředí a edge AI. Má tvořit mezivrstvu mezi DRAM a běžným NAND úložištěm: nabídnout vyšší hustotu než DRAM a zároveň lepší I/O výkon, nižší latenci a lepší energetickou efektivitu než konvenční NAND. 49
51
Obě technologie tedy řeší odlišné části paměťové hierarchie:
- zHBM má sloužit jako nejrychlejší paměťová vrstva těsně u akcelerátoru;
- zNAND-O má nabídnout hustší vrstvu pro data a modely, jejichž úplné držení v DRAM by bylo nákladné.
49
53
Samsung citoval test s GPT modelem o 120 miliardách parametrů, v němž zNAND-O dosáhlo stejného počtu tokenů za sekundu jako běžný DRAM server při šestinových provozních nákladech. Jde o test uváděný Samsungem, nikoli o obecnou garanci nákladů pro každé nasazení velkých modelů. 54
55
Firma technologii spojuje i s delší perspektivou velmi velkých modelů přímo v zařízeních a uvádí, že AI na zařízení s modely řádu bilionu parametrů by mohla být relevantní kolem roku 2030. 53
CXL nejspíš HBM při aktivním výpočtu nenahradí
Summit zároveň ukázal důležitý rozdíl na trhu AI pamětí: vyšší kapacita je užitečná, ale neznamená, že jsou všechny druhy paměti vzájemně zaměnitelné.
Daniel Morris z OpenAI, který se zabývá AI akcelerátory, uvedl, že pro samotné provozování AI modelů nenašel využití CXL. Potenciál vidí u dat, která se ve velkých modelech používají zřídka. Vidia Thiagarajan z Intelu podobně popsal sdílení paměti přes CXL jako doplněk sekundárního úložiště, nikoli náhradu HBM, a poukázal na rozdíl v propustnosti mezi pamětí připojenou přes CXL a HBM. 18
22
To neznamená, že CXL nemá smysl. Pravděpodobnější je vícevrstvá architektura: HBM u akcelerátoru pro výpočty citlivé na propustnost a CXL či další paměťové a úložné vrstvy pro kapacitu.
Co to znamená pro Samsung a SK hynix
V nejbližší době bude soutěž o HBM dál určovat schopnost paměť vyrobit ve velkém, kvalifikovat ji pro konkrétní platformy akcelerátorů a skutečně ji dodat. zHBM dává Samsungu odlišný dlouhodobý architektonický směr, neodstraňuje ale nutnost prokázat výtěžnost, tepelné chování, spolehlivost a integraci u zákazníků.
Skepticismus vůči tomu, že by CXL nahradilo lokální HBM při aktivním běhu modelů, zároveň podtrhuje význam vysokopropustné paměti v bezprostřední blízkosti akcelerátoru. Pro výrobce proto nebude rozhodující jen nejodvážnější 3D koncept, ale především to, kdo dokáže pokročilé pouzdření a paměťový návrh nejdřív proměnit v kvalifikovaný produkt vyráběný ve velkém objemu. 18
33
36
Shrnutí
Hlavní sdělení Samsungu zní, že výkon AI stále častěji omezuje přesun dat, kapacita paměti, spotřeba a teplo — nejen samotný výpočetní výkon. zHBM navrhuje přímé 3D vrstvení paměti nad akcelerátor, zatímco zNAND-O má dodat hustší sousední vrstvu pro rozsáhlejší AI úlohy.
Potenciální přínosy jsou výrazné, zatím však zůstávají cíli technologie ve fázi konceptu. Pro plánování AI infrastruktury je podstatný hlavně směr vývoje: systémy budou pravděpodobně stále více spoléhat na specializované vertikálně integrované paměťové vrstvy, přičemž HBM zůstane klíčová pro nejvýkonnější výpočetní cestu. 13
14
18
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Samsung zHBM: proč by paměť přímo na AI akcelerátoru mohla změnit výkon AI"?
Samsung tvrdí, že zHBM může zvýšit rychlost odezvy AI systémů více než desetinásobně, protože HBM umisťuje přímo nad AI akcelerátor, nikoli vedle něj.
What are the key points to validate first?
Samsung tvrdí, že zHBM může zvýšit rychlost odezvy AI systémů více než desetinásobně, protože HBM umisťuje přímo nad AI akcelerátor, nikoli vedle něj. Pro rozhraní využívající zHBM firma uvádí cíl přibližně 8× vyššího výkonu než u HBM5, více než 10× vyšší hustoty paměti, 3× lepší energetické efektivity a více než o polovinu nižšího tepelného odporu.
What should I do next in practice?
Inženýři z OpenAI a Intelu na stejném summitu zpochybnili, že by CXL mohlo při aktivním běhu AI modelů nahradit HBM; spíše jej vidí jako doplňkovou kapacitní vrstvu.
Sources
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push