منشورات AI الرائجة وأبحاث سريعة المتابعة - الصفحة 95
ما هي معمارية Peerium من هواوي؟ مليون معالج بوصفه حاسوباً منطقياً واحداً
20 المصادر0Peerium معمارية لتنسيق المعالجات والموارد، وليست شريحة جديدة من عائلة Ascend. أما تشغيل نحو مليون معالج كحاسوب منطقي واحد فهو هدف معلن، لا نشر مكتمل ثبت أداؤه.
شريحة Zhenwu V900 من علي بابا: مواصفات معلنة ووعد بأداء أعلى ثلاثة أضعاف
17 المصادر0قدّمت T Head شريحة Zhenwu V900 للتدريب والاستدلال، وتقول علي بابا إن أداءها يبلغ ثلاثة أضعاف أداء M890؛ ولم يُثبت هذا الرقم باختبار مستقل.
نموذج Xing4.0-29B-A4B: المواصفات والتشغيل وما تعنيه أرقام الأداء
19 المصادر0يضم النموذج نحو 29 مليار معامل إجمالًا، لكنه يفعّل قرابة 4 مليارات لكل رمز؛ وهذا لا يعني أن تشغيله يتطلب تخزين 4 مليارات معامل فقط.
ثلاثية MachEmbodied من لي أوتو: كيف تتكامل النماذج، وما الذي لم تثبته بعد؟
14 المصادر0قدّمت لي أوتو في ٢٢ سبتمبر ٢٠٢٦ نظام ME Brain 1.0، ونموذج الرؤية واللغة ME VLM، ونموذج الفهم وتوليد الأفعال ME U0.
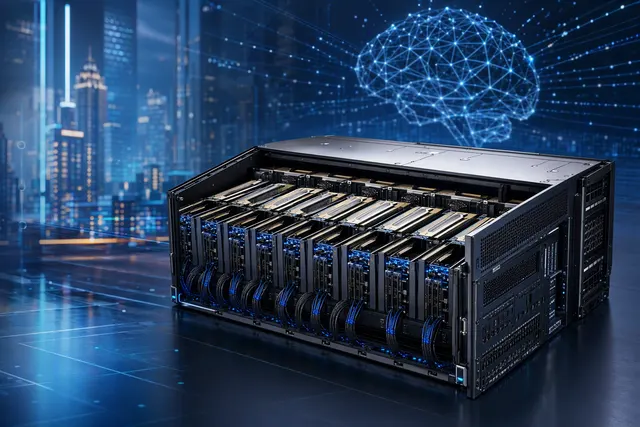
MetaBrain SD200 Ultra من إنسبور: ماذا تعني أرقام الأداء للمشترين؟
17 المصادر0تقول إنسبور إن SD200 Ultra يضم 128 مسرّعًا للذكاء الاصطناعي وذاكرة موحّدة العنونة للمسرّعات بسعة 8 تيرابايت، ويمكنه تشغيل Kimi K3 ذي 2.8 تريليون معلمة على جهاز واحد.
الصين تبني ملامح مركز بيانات في المدار.. لكن عبر أقمار متفرقة
25 المصادر0أطلقت الصين أول 12 قمرًا من كوكبة للحوسبة بالذكاء الاصطناعي، وبدأت تقديم خدمات حوسبة مدارية تجريبية، وسجلت سرعة قصوى بلغت 120 غيغابت في الثانية في تجربة اتصال ليزري من قمر إلى الأرض.[11][46][21]
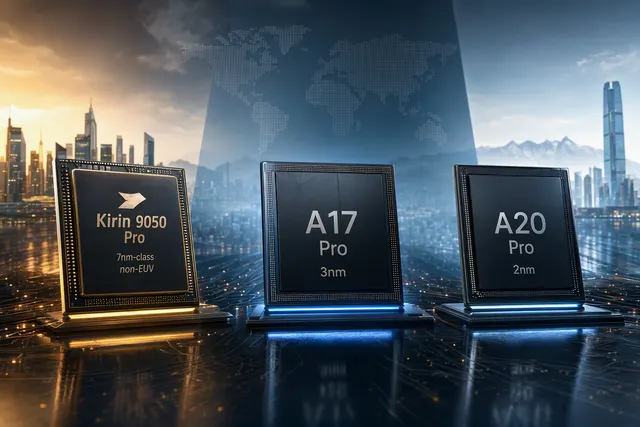
كيرين 9050 برو يتفوق على شريحة أبل أقدم في اختبار واحد.. فأين يقف أمام الأحدث؟
21 المصادر0بحسب تقييم برنشتاين، تفوق كيرين 9050 برو على A17 Pro في اختبار Geekbench 6 متعدد الأنوية، لكنه يتأخر عن A20 Pro الأحدث بنحو 30% في التقييم الإجمالي.
Qwen 4 قيد التدريب ولم يُطرح بعد: ما أعلنته علي بابا في مؤتمر أبسارا 2026
23 المصادر0أكدت علي بابا في 22 سبتمبر 2026 أن Qwen 4 قيد التدريب، لا أنه متاح للاستخدام. أما نطاق 5–10 تريليونات مُعامِل فهو هدف مستقبلي لسلسلتي Qwen 4.5 وQwen 5.
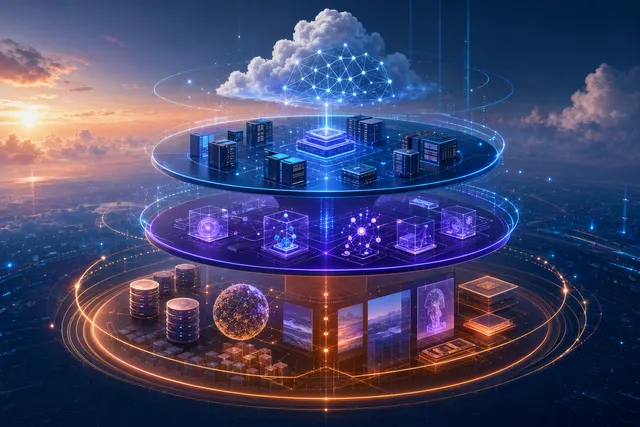
سحابة علي بابا للوكيل الذكي: كيف تتكامل AgentCore وCPFS وHPN 8.0 Pro؟
17 المصادر0تقسم علي بابا كلاود استراتيجيتها إلى ثلاثة احتياجات: النموذج، وبيئة تشغيل الوكيل، والسياق؛ وتقابلها ثلاث طبقات سحابية.[3][4]
نماذج الصوت من علي بابا في مؤتمر أبسارا ٢٠٢٦: ما الفرق بين الترجمة الفورية وتوليد الصوت؟
16 المصادر0عرضت علي بابا نموذجًا للترجمة الفورية أثناء الكلام، إلى جانب خمسة نماذج ضمن عائلة Qwen Audio 3.1.
جدل رفع مستودعات ZCode: ما الذي أصلحته «تشيبو» وما حدود نتائج التدقيق؟
22 المصادر0كشف باحث أن ZCode كان يحزم مساحة عمل المستخدم المسجّل دخوله، بما فيها سجل Git، ويرفع نسخة مشفّرة إلى تخزين سحابي؛ ثم نشرت «تشيبو» الشيفرة وأزالت مسار الرفع في الإصدار 3.14.0.
OceanStor M900 من هواوي: كيف تعمل ذاكرة KV المشتركة بسعة 64 بيتابايت؟
19 المصادر0تقول هواوي إن OceanStor M900 يتيح لمجموعة واحدة من خوادم SuperPoD مشاركة ذاكرة KV مؤقتة بسعة تصل إلى 64 بيتابايت؛ وهي سعة على مستوى المجموعة، لا داخل كل وحدة معالجة.