انهيار النماذج في الذكاء الاصطناعي: خطر تدريب الأنظمة على بيانات اصطناعية
تشير أبحاث حديثة إلى أن تدريب نماذج الذكاء الاصطناعي بشكل متكرر على بيانات اصطناعية يؤدي إلى ظاهرة تُسمى «انهيار النماذج»، حيث تختفي الأنماط النادرة وتصبح المخرجات أقل تنوعاً. التدريب التكراري يضخم الانحياز الإحصائي: الأحداث النادرة في أطراف التوزيع تظهر أقل فأقل في البيانات الاصطناعية حتى تختفي تماماً.
نشر بواسطةتم التحرير باستخدام GPT-5.5تم إنشاء الصور باستخدام GPT Image 2
تشير أبحاث حديثة إلى أن تدريب نماذج الذكاء الاصطناعي بشكل متكرر على بيانات اصطناعية يؤدي إلى ظاهرة تُسمى «انهيار النماذج»، حيث تختفي الأنماط النادرة وتصبح المخرجات أقل تنوعاً.
التدريب التكراري يضخم الانحياز الإحصائي: الأحداث النادرة في أطراف التوزيع تظهر أقل فأقل في البيانات الاصطناعية حتى تختفي تماماً.
تشير دراسات تحليلية إلى أن وجود قدر صغير جداً من البيانات الحقيقية أو إدخال معرفة مسبقة في النموذج يمكن أن يثبت عملية التدريب ويمنع الانهيار.
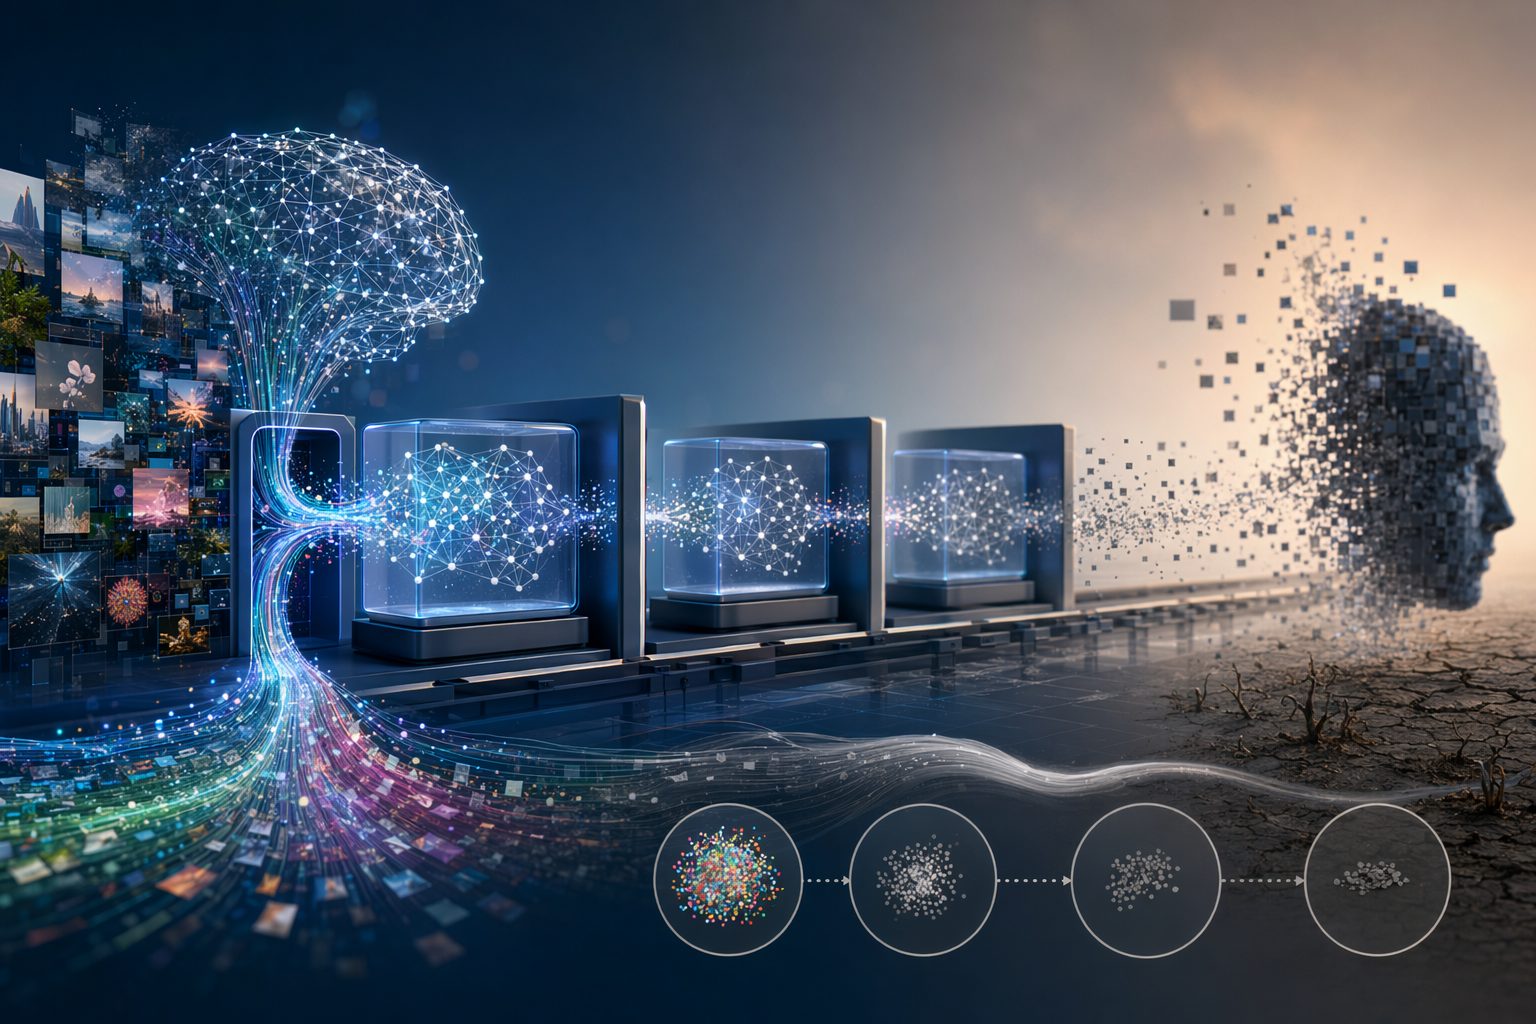
What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursiveRecursive training on AI‑generated data can gradually erase rare patterns from a model’s learned distribution, a phenomenon researchers call model collapse.
موجّه الذكاء الاصطناعي
Create a landscape editorial hero image for this Studio Global article: What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursive. Article summary: The study describes model collapse as a failure mode where recursively trained generative models lose information about the original data distribution, especially its rare or low-probability regions.. Topic tags: general, government, education, academic, general web. Reference image context from search candidates: Reference image 1: visual subject "However, as AI-generated data increasingly populates the internet, an important question arises: What happens when new AI models are trained on datasets containing their previous o" source context "Avoiding Model Collapse in AI Training - Risk Insight" Reference image 2: visual subject "Artificial intelligence models
openai.com
تزداد أنظمة الذكاء الاصطناعي التوليدي اعتماداً على البيانات الاصطناعية—أي المحتوى الذي تنتجه نماذج ذكاء اصطناعي سابقة. لكن الأبحاث الحديثة تشير إلى خطر مهم يُعرف باسم انهيار النماذج (Model Collapse): وهو تدهور تدريجي يجعل النماذج تفقد قدرتها على تمثيل التنوع الكامل للبيانات الأصلية.
أظهرت دراسات حول التدريب التكراري أنه عندما تتعلم النماذج الجديدة من مخرجات نماذج سابقة بدلاً من بيانات واقعية من البشر أو العالم الحقيقي، تبدأ الأنماط النادرة في الاختفاء تدريجياً. ومع مرور عدة دورات تدريبية، يتراكم هذا الفقدان حتى يصبح تمثيل النموذج للواقع مشوهاً أو ناقصاً.
Studio Global AI
مواصلة البحث الخاص بك
تتضمن هذه الصفحة إجابة مدعومة بالمصدر يمكنك المتابعة داخل Studio Global.
ما هي الإجابة المختصرة على "انهيار النماذج في الذكاء الاصطناعي: خطر تدريب الأنظمة على بيانات اصطناعية"؟
تشير أبحاث حديثة إلى أن تدريب نماذج الذكاء الاصطناعي بشكل متكرر على بيانات اصطناعية يؤدي إلى ظاهرة تُسمى «انهيار النماذج»، حيث تختفي الأنماط النادرة وتصبح المخرجات أقل تنوعاً.
ما هي النقاط الأساسية التي يجب التحقق منها أولاً؟
تشير أبحاث حديثة إلى أن تدريب نماذج الذكاء الاصطناعي بشكل متكرر على بيانات اصطناعية يؤدي إلى ظاهرة تُسمى «انهيار النماذج»، حيث تختفي الأنماط النادرة وتصبح المخرجات أقل تنوعاً. التدريب التكراري يضخم الانحياز الإحصائي: الأحداث النادرة في أطراف التوزيع تظهر أقل فأقل في البيانات الاصطناعية حتى تختفي تماماً.
ماذا يجب أن أفعل بعد ذلك في الممارسة العملية؟
تشير دراسات تحليلية إلى أن وجود قدر صغير جداً من البيانات الحقيقية أو إدخال معرفة مسبقة في النموذج يمكن أن يثبت عملية التدريب ويمنع الانهيار.
ومع انتشار المحتوى الذي ينتجه الذكاء الاصطناعي على الإنترنت—والذي أصبح جزءاً متزايداً من البيانات المستخدمة في تدريب النماذج—أصبح فهم هذه الظاهرة وكيفية منعها أمراً بالغ الأهمية.
ما المقصود بانهيار النماذج؟
يشير مصطلح انهيار النماذج إلى حالة فشل تحدث عندما تُدرَّب النماذج التوليدية على بيانات أنتجتها نماذج أخرى بدلاً من البيانات البشرية الأصلية.
وجد الباحثون أن التدريب التكراري يسبب ما وصفوه بـ عيوب لا يمكن عكسها: إذ تفقد النماذج تدريجياً المعلومات الموجودة في "ذيول التوزيع الإحصائي"—أي الأمثلة النادرة أو غير المعتادة التي تظهر قليلاً لكنها ضرورية لفهم الواقع بدقة.
مع الوقت، تصبح مخرجات النموذج:
أقل تنوعاً
أكثر تركيزاً على الأنماط الشائعة فقط
أقل قدرة على تمثيل الحالات غير المعتادة
وقد لوحظت هذه الظاهرة في عدة أنواع من النماذج التوليدية، منها:
النماذج اللغوية الكبيرة (LLMs)
المشفرات التلقائية المتغيرة (VAEs)
نماذج المزيج الغاوسي (GMMs)
وظهور المشكلة عبر عدة عائلات من النماذج يشير إلى أنها ليست مشكلة تقنية خاصة بنموذج معين، بل خاصية عامة قد تظهر عندما يتم التدريب بشكل متكرر على بيانات اصطناعية.
لماذا يختفي النمط النادر مع التدريب التكراري؟
السبب يعود في الأساس إلى طريقة أخذ العينات الإحصائية.
عندما يولد نموذج ذكاء اصطناعي بيانات جديدة، فإنه يميل بطبيعته إلى إنتاج الأنماط ذات الاحتمال الأعلى أكثر من الأنماط النادرة. هذه الأنماط النادرة تقع في أطراف التوزيع الإحصائي، وهي أصلاً قليلة الظهور.
عند استخدام هذه البيانات الاصطناعية لتدريب الجيل التالي من النماذج يحدث ما يلي:
تظهر الأمثلة النادرة بشكل أقل من السابق
يتعلم النموذج توزيعاً إحصائياً مشوهاً قليلاً
يتضاعف التشويه مع كل جيل جديد من النماذج
مع تكرار العملية، تختفي أطراف التوزيع تدريجياً، وتبقى فقط الأنماط الأكثر شيوعاً.
وبمجرد اختفاء هذه الأمثلة من بيانات التدريب، يصبح من المستحيل تقريباً للنماذج اللاحقة إعادة اكتشافها، لأن الدليل على وجودها لم يعد موجوداً في البيانات.
كيف يمكن لبيانات حقيقية قليلة أن تمنع الانهيار؟
من النتائج اللافتة في التحليلات الحديثة أن كمية صغيرة جداً من البيانات الواقعية قد تكون كافية لمنع الانهيار.
في دراسة تحليلية استخدمت نماذج إحصائية تُعرف باسم العائلات الأسية (Exponential Families)، وجد الباحثون أن إدخال حتى نقطة بيانات واحدة من التوزيع الحقيقي يمكن أن يعمل كمرساة للنموذج. هذه النقطة تحافظ على دليل إحصائي على وجود الأنماط النادرة، مما يمنع التدريب التكراري من الانجراف نحو توزيع خاطئ.
هناك طريقة أخرى لتحقيق التأثير نفسه وهي استخدام المعرفة المسبقة (Prior Knowledge) داخل النموذج. فهذه القيود أو الافتراضات المدمجة تحدد شكل التوزيعات الممكنة التي يمكن للنموذج تعلمها، وبالتالي تمنع الانحراف الكامل نحو الأنماط المتحيزة الموجودة في البيانات الاصطناعية.
بعبارة أخرى:
البيانات الواقعية تحفظ الأنماط النادرة في التوزيع
المعرفة المسبقة تمنع النموذج من الابتعاد كثيراً عن الواقع
حتى عندما تكون البيانات الاصطناعية أكثر بكثير من البيانات الحقيقية، يمكن لهذه "المراسي" أن تثبت عملية التعلم.
لماذا يشكل ذلك مشكلة للنماذج اللغوية الكبيرة؟
تزداد أهمية هذه المشكلة مع انتشار المحتوى الذي يولده الذكاء الاصطناعي على الإنترنت.
تعتمد النماذج اللغوية الكبيرة عادة على مجموعات بيانات ضخمة مأخوذة من الويب. ومع ازدياد النصوص التي ينتجها الذكاء الاصطناعي، قد تصبح هذه المجموعات مختلطة بكمية كبيرة من المحتوى الاصطناعي الناتج عن نماذج سابقة.
إذا تم تدريب النماذج المستقبلية بشكل أساسي على هذه البيانات، فقد يحدث انحراف تدريجي بعيداً عن ثراء اللغة والمعرفة البشرية.
النتائج المحتملة قد تشمل:
انخفاض تنوع النصوص التي يولدها النموذج
ضعف في التعامل مع الحالات النادرة أو غير المعتادة
تمثيل أضيق للمعرفة البشرية والواقع
لهذا يحذر الباحثون من أن الحفاظ على مصادر موثوقة من البيانات البشرية الأصلية أو استخدام تقنيات تحافظ على التوزيع الحقيقي للبيانات أصبح أمراً ضرورياً لاستمرار تطوير أنظمة الذكاء الاصطناعي بدقة وموثوقية.
ما الذي لا يزال غير واضح؟
رغم أن آلية انهيار النماذج مدعومة بأدلة قوية، فإن بعض التفاصيل ما تزال قيد البحث.
فعلى سبيل المثال، فكرة أن نقطة بيانات حقيقية واحدة قد تمنع الانهيار جاءت من تحليلات نظرية ونماذج إحصائية مبسطة، وليس من تجارب تدريب ضخمة على نماذج لغوية كبيرة في بيئات الإنتاج.
لذلك قد يختلف مقدار البيانات الواقعية المطلوبة عملياً حسب:
بنية النموذج
حجم البيانات
طريقة التدريب المستخدمة
لكن الرسالة الأساسية واضحة: الاعتماد الكامل على بيانات يولدها الذكاء الاصطناعي قد يؤدي تدريجياً إلى محو أجزاء من الواقع من النماذج نفسها. والحفاظ على اتصال دائم بالبيانات الحقيقية يظل ضرورياً للحفاظ على دقة هذه الأنظمة مع مرور الوقت.
arxiv.org
Lost in Retraining: Roaming the Parameter Space of ...